چرا موتورهای جستوجو و دستیارهای هوش مصنوعی افراد همنام را با هم اشتباه میگیرند
پیوند موجودیت چطور تصمیم میگیرد یک نام به کدام شخص اشاره دارد، چرا پژوهشها نشان میدهند مدلهای زبانی دربارهی افراد کمتر شناختهشده ضعیفترین عملکرد را دارند، و چه چیزی تشخیص پروفایلهای شما را آسان میکند.
 پارسا علیزاده
۵ دقیقه مطالعه
در این صفحه
وقتی از یک دستیار هوش مصنوعی پرسیدم من کی هستم، وبسایتم را پیدا کرد، اما به یک پروفایل GitHub پیوند داد که مال شخص دیگری با همین نام بود. این یک خطای نادر نیست. تطبیق دادن یک نام با شخص درست مسئلهای دشوار و بهخوبی مطالعهشده است، و هم موتورهای جستوجو و هم مدلهای زبانی آن را با نشانههایی حل میکنند که به نفع افرادی است که از قبل شناختهشدهاند. این نوشته توضیح میدهد این تطبیق چطور کار میکند، پژوهشها دربارهی جاهایی که شکست میخورد چه میگویند، و شما چه کاری میتوانید دربارهاش بکنید.
رشتهها و چیزها#
نام یک رشته (string) است. شخص یک چیز (thing) است. Google در سال ۲۰۱۲ Knowledge Graph خود را با عبارت «چیزها، نه رشتهها» (things, not strings) توصیف کرد: هدف این بود که جستوجو بفهمد یک پرسش به کدام موجودیت واقعی اشاره دارد، نه اینکه فقط بداند کدام صفحهها آن واژهها را دارند [1].
گامی که این دو را به هم وصل میکند پیوند موجودیت (entity linking) یا ابهامزدایی از موجودیتهای نامدار (named entity disambiguation) نام دارد. وقتی در صفحهای به نامی مثل «Parsa Alizadeh» برمیخورد، سامانه باید تصمیم بگیرد که این نام به کدام موجودیت اشاره دارد، اگر اصلاً به موجودیتی اشاره داشته باشد.
پیوند موجودیت چطور تصمیم میگیرد#
سامانهی AIDA از Johannes Hoffart و همکارانش توصیفی کلاسیک از این مسئله است [2]. این سامانه سه نوع شاهد را با هم ترکیب میکند [2]:
- احتمال پیشین (prior probability): این نام بهطور کلی چقدر به هر نامزد اشاره دارد. یک همنامِ مشهور احتمال پیشین بالایی دارد.
- شباهت بافت (context similarity): واژههای اطراف آن اشاره چقدر با آنچه دربارهی هر نامزد میدانیم جور درمیآیند.
- انسجام (coherence): آیا نامزد با دیگر موجودیتهای همان صفحه سازگار است. اشارهای که کنار «React» و «Next.js» آمده با یک توسعهدهندهی نرمافزار جورتر است تا با یک ورزشکار.
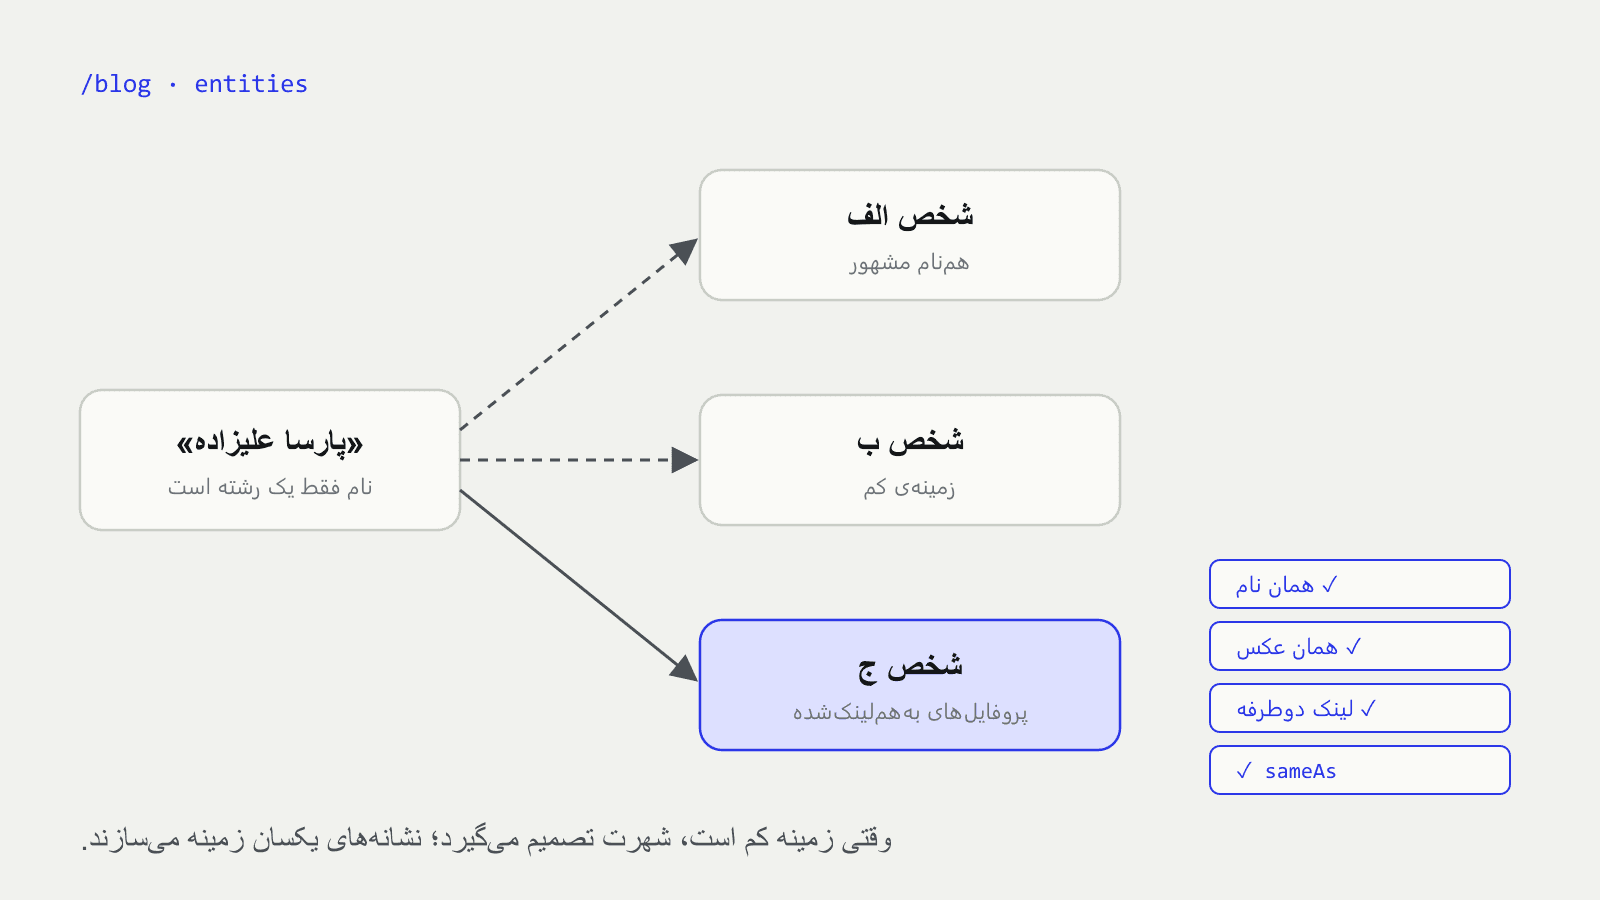
برای هر کسی که مشهور نیست، احتمال پیشین بخش مهم ماجراست. وقتی بافت کممایه باشد، سامانه به محبوبیت تکیه میکند و شخص شناختهشدهترِ همنام برنده میشود.
چرا مدلهای زبانی با افراد کمتر شناختهشده مشکل دارند#
مدلهای زبانی هم مشکل مشابهی دارند که در چند پژوهش مستقیماً اندازهگیری شده است.
Nikhil Kandpal و همکارانش دریافتند که توانایی یک مدل در پاسخ به یک پرسش واقعیتمحور ارتباط تنگاتنگی با تعداد اسنادی دارد که دربارهی آن واقعیت در دادههای آموزشیاش آمدهاند [3]. واقعیتهایی که بهندرت ظاهر میشوند، یعنی دنبالهی بلند (long tail)، با دقت بسیار کمتری پاسخ داده میشوند [3].
Alex Mallen و همکارانش با پرسشهایی دربارهی موجودیتهایی با میزان محبوبیت متفاوت به همین نتیجه رسیدند [4]. مدلها دربارهی موجودیتهای محبوب خوب عمل کردند و دربارهی موجودیتهای کممحبوبتر ضعیف، و بازیابی اسناد مرتبط دقیقاً همانجا بیشترین کمک را کرد که حافظهی خودِ مدل ضعیفتر بود [4].
زندگینامهها آزمونی مستقیماند. FActScore، از Sewon Min و همکارانش، زندگینامههای تولیدشده را به واقعیتهای جداگانه میشکند و هر یک را بررسی میکند [5]. در ارزیابی آنها، دقت واقعیتسنجی (factual precision) زندگینامههای ChatGPT حدود ۵۸٪ بود و نرخ خطا برای افراد کمتر شناختهشده بالاتر بود [5].
پس برای کسی که ردپای آنلاین کوچکی دارد، دستیار حافظهی قابلاعتماد چندانی ندارد و به آنچه بازیابی میکند وابسته است. اگر جستوجوی آن نام پروفایل GitHub یک همنام را برگرداند، ممکن است دستیار آن را به شما نسبت دهد.
قابلتشخیص کردن خودتان#
هر یک از گامهای زیر شباهت بافت یا انسجام را افزایش میدهد، یعنی دو نشانهای که در اختیار شماست.
همهجا از یک شکل نام استفاده کنید. همان املا در وبسایت، GitHub، LinkedIn و دیگر پروفایلهایتان. اگر نامتان را به خط دیگری هم مینویسید، مثلاً فارسی، هر دو شکل را کنار هم منتشر کنید تا به هم وصل شوند.
همهجا از یک عکس استفاده کنید. عکس پروفایل یکسان در سایتهای مختلف نشانهی تطبیق سادهای است، هم برای آدمها و هم برای سامانههایی که تصاویر را مقایسه میکنند. یک لوگو یا عکسی متفاوت در هر سایت این پیوند را میشکند.
پیوند دوطرفه بدهید. وبسایتتان باید به هر پروفایل پیوند دهد و هر پروفایل باید به وبسایتتان برگردد. پیوند یکطرفه یک ادعاست؛ پیوند برگشتی تأیید آن است.
آن را در دادهی ساختاریافته بگویید. ویژگی sameAs در schema.org بهعنوان نشانی (URL) صفحهای تعریف شده که هویت آن مورد را بیابهام نشان میدهد [6]. فهرست کردن پروفایلهایتان در sameAs روی یک موجودیت Person به موتورهای جستوجو میگوید که این صفحهها متعلق به یک شخصاند. Google نشانهگذاری ProfilePage را برای صفحههایی دربارهی یک شخص مستند کرده است [7]. شرح کاملش در دادهی ساختاریافته برای وبسایت شخصی آمده است.
بافت متمایزکننده اضافه کنید. نقش، حوزه و محل زندگیتان را کنار نامتان بیاورید، با همان واژهها در همهی پروفایلها. «Parsa Alizadeh, software developer, web, mobile and AI» چیزی برای تطبیق به سامانه میدهد که همنامتان در آن شریک نیست.
چیزهایی منتشر کنید که فقط شما منتشر میکنید. مقالهها و پروژههایی که به نام شما هستند اسنادی میافزایند که از شما همراه با حوزهی کاریتان نام میبرند. این دقیقاً همان شاهدی است که پژوهشهای بالا نشان میدهند برای افراد کمتر شناختهشده وجود ندارد [3] [4].
برای اینکه ببینید همهی اینها چطور در یک سایت کنار هم قرار میگیرند، ساختن سایتی که موتورهای جستوجو بفهمند را ببینید، و برای اینکه موتورهای پاسخگوی هوش مصنوعی چطور منابع را انتخاب میکنند، پژوهش دربارهی بهینهسازی برای موتورهای مولد را.
جمعبندی#
- پیوند موجودیت با استفاده از محبوبیت، بافت و انسجام یک شخص را انتخاب میکند [2]؛ وقتی بافت کممایه باشد، همنامِ مشهور برنده میشود.
- مدلهای زبانی دربارهی افرادی که کمتر از آنها نام برده شده کمترین دقت را دارند [3] [4] [5]، پس به بازیابی تکیه میکنند که ممکن است یک همنام را پیش بکشد.
- بافت و انسجام در اختیار شماست: یک نام، یک عکس، پیوند در هر دو جهت،
sameAs[6]، توصیفهای یکسان و آثار منتشرشدهی خودتان.
منابع#
- Singhal, A. “Introducing the Knowledge Graph: things, not strings.” Google, 2012. https://blog.google/products/search/introducing-knowledge-graph-things-not/
- Hoffart, J., Yosef, M. A., Bordino, I., Fürstenau, H., Pinkal, M., Spaniol, M., Taneva, B., Thater, S., Weikum, G. “Robust Disambiguation of Named Entities in Text.” EMNLP 2011. https://aclanthology.org/D11-1072/
- Kandpal, N., Deng, H., Roberts, A., Wallace, E., Raffel, C. “Large Language Models Struggle to Learn Long-Tail Knowledge.” ICML 2023. https://arxiv.org/abs/2211.08411
- Mallen, A., Asai, A., Zhong, V., Das, R., Khashabi, D., Hajishirzi, H. “When Not to Trust Language Models: Investigating Effectiveness of Parametric and Non-Parametric Memories.” ACL 2023. https://arxiv.org/abs/2212.10511
- Min, S., Krishna, K., Lyu, X., Lewis, M., Yih, W., Koh, P. W., Iyyer, M., Zettlemoyer, L., Hajishirzi, H. “FActScore: Fine-grained Atomic Evaluation of Factual Precision in Long Form Text Generation.” EMNLP 2023. https://arxiv.org/abs/2305.14251
- Schema.org. “sameAs.” https://schema.org/sameAs
- Google Search Central. “Profile page (ProfilePage) structured data.” https://developers.google.com/search/docs/appearance/structured-data/profile-page
- #seo
- #geo
- #entities
- #ai
- #research
نوشتهی پارسا علیزاده
محصولات وب و موبایل را از صفر تا انتشار میسازم، همراه با ابزارهای هوش مصنوعی که آنها را هوشمندتر میکنند. رابطهای سریع، سیستمهای تمیز و تحویل بهموقع برایم مهم است.