مدلهای زبانی متن را چطور میخوانند: توکن، BPE و اینکه چرا فارسی گرانتر تمام میشود
توکن چیست، BPE چطور واژگان میسازد، چرا فارسی و ترکی توکن بیشتری از انگلیسی میگیرند، و چطور بهجای حدس زدن توکنها را بشماریم.
 پارسا علیزاده
۴ دقیقه مطالعه
در این صفحه
یک مدل زبانی هیچوقت حرف یا واژه نمیبیند. او توکن میبیند: تکههای شمارهدار متن که گاهی یک واژهی کاملاند و گاهی فقط بخشی از آن. همهی محدودیتها و همهی قیمتها در محصولات مبتنی بر LLM با توکن شمرده میشوند: پنجرهی متن (context window)، سقف خروجی و صورتحساب. این نوشته توضیح میدهد توکن چیست، رایجترین روش چطور واژگانش را میسازد، و چرا یک جملهی یکسان در فارسی یا ترکی گرانتر از انگلیسی تمام میشود.
چرا واژه یا نویسه نه#
اگر متن را بر اساس واژهها بشکنیم دنبالهها کوتاه میشوند، اما واژگان هیچوقت تمام نمیشود. اسمها، غلطهای تایپی، کد و اصطلاحات تازه همه بیرون از آن میمانند، و مدل نمیتواند واژهای را بخواند که برایش مدخلی ندارد. شکستن بر اساس نویسهها مشکل برعکس دارد: هیچچیز ناشناخته نیست، اما دنبالهها خیلی بلند میشوند و مدل باید پیش از معنا، املا یاد بگیرد.
توکنسازی زیرواژهای (subword) بین این دو قرار میگیرد. واژههای پرتکرار یک توکن میشوند و واژههای کمتکرار از تکههای کوچکتر هجی میشوند. Sennrich، Haddow و Birch این روش را برای مدلهای ترجمه معرفی کردند: واژههای نادر و ناشناخته بهصورت دنبالهای از واحدهای زیرواژهای رمز میشوند، با تقطیعی که بر پایهی الگوریتم فشردهسازی byte pair encoding است [1].
BPE چطور واژگان را یاد میگیرد#
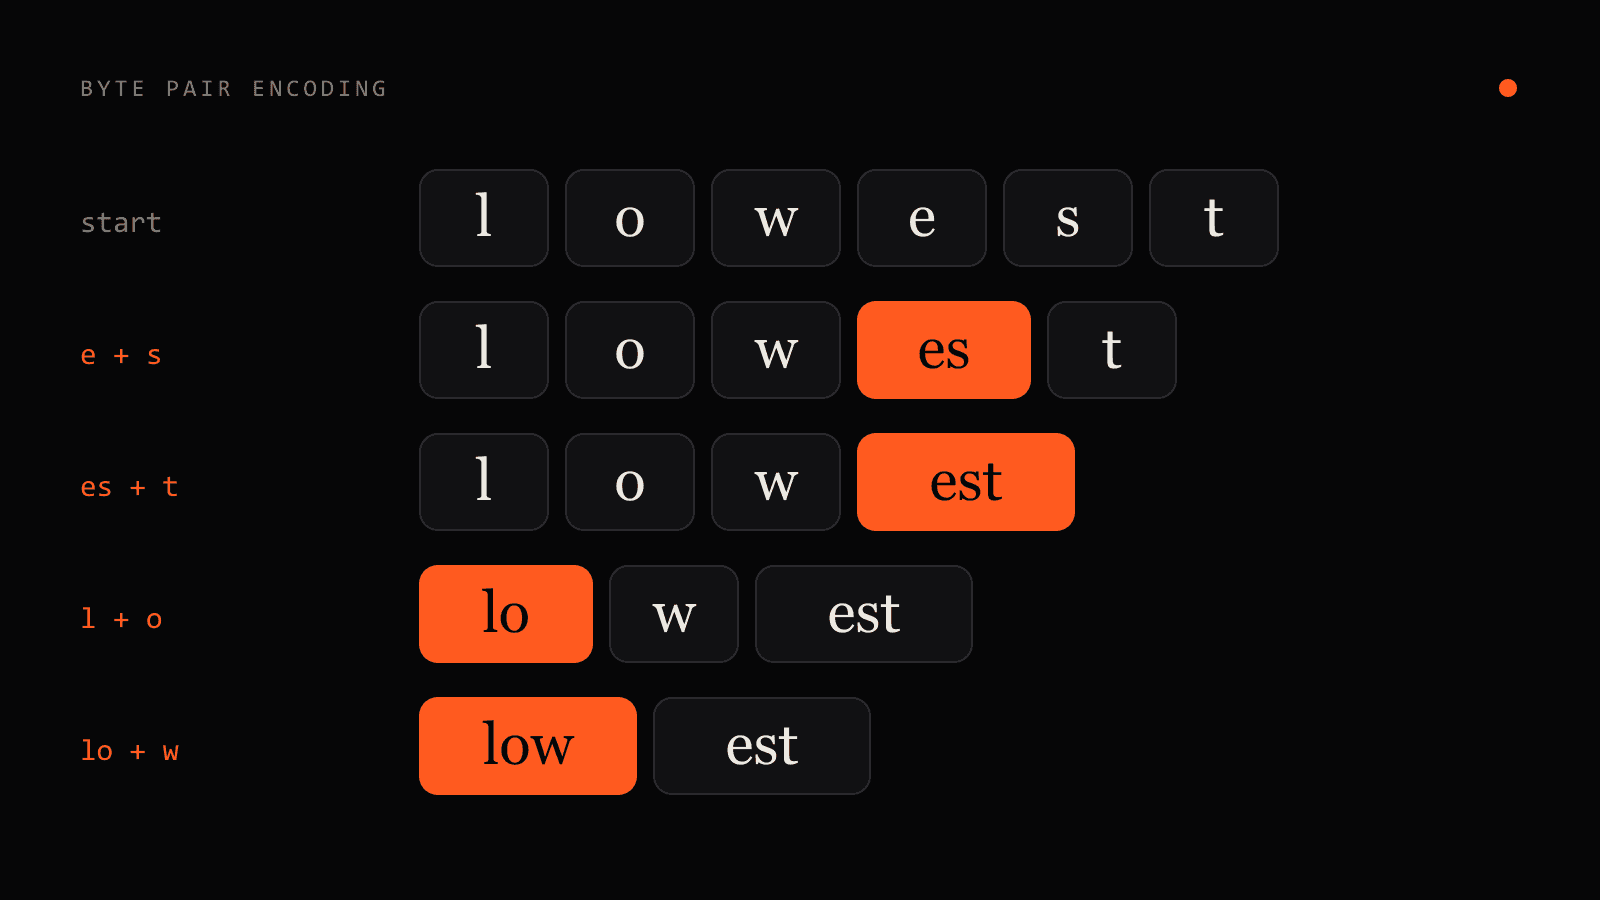
رمزگذاری جفتبایت (BPE) از کوچکترین واحدها شروع میکند و یک گام را تکرار میکند: همهی جفتهای کنار هم را بشمار و پرتکرارترین جفت را به یک واحد جدید تبدیل کن. فهرست این ادغامها، به ترتیب، همان توکنساز است.
یک پیکرهی آزمایشی با چهار واژه و تعداد تکرارشان این را نشان میدهد:
low × 5     lower × 2     newest × 6     widest × 3

start    l o w        l o w e r      n e w e s t     w i d e s t
merge 1  e + s → es   (9 times: newest 6 + widest 3)
merge 2  es + t → est (9 times)
merge 3  l + o → lo   (7 times: low 5 + lower 2)
merge 4  lo + w → low (7 times)

result   low          low e r        n e w est       w i d est
بعد از چهار ادغام، «low» یک توکن است و «est» یک پسوند قابلاستفادهی دوباره. واژهای که توکنساز هرگز ندیده، مثل «lowest»، بهجای خطا دادن به شکل low + est درمیآید. توکنسازهای واقعی دهها هزار ادغام را روی پیکرهای بسیار بزرگ انجام میدهند، اما حلقه همین است.
فایل README کتابخانهی tiktoken ویژگیهایی را که این روش را کاربردی میکنند فهرست کرده است: برگشتپذیر و بدون اتلاف است، یعنی توکنها دوباره به متن اصلی تبدیل میشوند، و روی هر متنی کار میکند، حتی متنی که در دادهی آموزشی توکنساز نبوده. یک میانگین عملی هم میدهد: هر توکن حدوداً معادل ۴ بایت است [2].
چرا یک جملهی یکسان بیرون از انگلیسی گرانتر است#
دو چیز به ضرر زبانهایی مثل فارسی و ترکی کار میکند.
اولی بایت است. توکنسازی که از بایت شروع میکند، مثل BPE در سطح بایت، متن را به شکل UTF-8 میبیند. در UTF-8 نویسههای تا U+007F یک بایت و نویسههای U+0080 تا U+07FF دو بایت میگیرند [6]. همهی حروف خط عربی که برای فارسی به کار میرود، و حروف ترکی مثل ş، ğ و ı، در همین بازهی دوم هستند:
"salam"   5 characters   5 bytes
"سلام"    4 characters   8 bytes
دومی دادهی آموزشی است. ادغامها از روی فراوانی یاد گرفته میشوند. توکنسازی که بیشتر روی متن انگلیسی آموزش دیده، تکههای بلند انگلیسی یاد میگیرد و برای بقیه فقط تکههای کوتاه؛ پس زبانهای دیگر به بایتهای خام نزدیکتر میمانند.
این موضوع اندازهگیری شده است. Petrov و همکارانش نشان دادند که یک متن یکسان وقتی به زبانهای مختلف ترجمه شود میتواند طول توکنسازی بسیار متفاوتی داشته باشد، با اختلافی که در بعضی موارد تا ۱۵ برابر میرسد. آنها به پیامدها هم اشاره میکنند: هزینهی استفاده از سرویسهای تجاری زبان، زمان پردازش و تأخیر، و مقدار محتوایی که در پنجرهی متن جا میشود [5].
راهنمای خود OpenAI هم با این سازگار است. برای انگلیسی قاعدههای سرانگشتی میدهد (یک توکن تقریباً ۴ نویسه یا سهچهارم یک واژه است) و اضافه میکند که اینها برآورد هستند و در زبانهای دیگر رابطهی نویسه، واژه و توکن میتواند متفاوت باشد [3].
توکنسازهای دیگر#
BPE تنها روش نیست. SentencePiece مدلهای زیرواژهای را مستقیماً از جملههای خام آموزش میدهد، در حالی که ابزارهای قبلی فرض میکردند متن از پیش به واژهها شکسته شده است [4]. این برای زبانهایی که بین واژهها فاصله نمیگذارند مهم است. هر خانوادهی مدل توکنساز خودش را دارد، پس تعداد توکنی که با یکی شمردهاید برای دیگری معتبر نیست.
در عمل چه کنیم#
بشمارید، حدس نزنید. توکنسازِ همان مدلی را که صدا میزنید اجرا کنید:
import tiktoken

enc = tiktoken.get_encoding("cl100k_base")
tokens = enc.encode("Your prompt goes here")
print(len(tokens))
چند عادت از بخشهای بالا نتیجه میشود:
- پرامپتها را به زبانی اندازه بگیرید که کاربرانتان مینویسند. بودجهای که فقط با انگلیسی آزمایش شده برای فارسی یا ترکی کم میآید.
- اندازهی تکههای بازیابی را با توکن تعیین کنید، نه با نویسه، تا در هر زبانی یک معنا داشته باشد. دربارهی تکهبندی در تولید تقویتشده با بازیابی نوشتهام.
- برای پاسخ جا بگذارید. ورودی و خروجی از یک پنجرهی متن مشترک استفاده میکنند؛ توضیحش در ترنسفورمر، از روی مقالهی اصلی هست.
- با عوض کردن مدل دوباره بشمارید. توکنساز دیگر برای همان متن عدد دیگری میدهد.
جمعبندی#
- توکن تکهای از متن از یک واژگان ثابت است؛ محدودیتها و قیمتها با توکن شمرده میشوند.
- BPE این واژگان را با ادغام پیاپی پرتکرارترین جفت کنار هم میسازد [1].
- برگشتپذیر است و روی هر متنی کار میکند، با میانگین حدود ۴ بایت برای هر توکن [2].
- متن غیرانگلیسی معمولاً توکن بیشتری لازم دارد: بایت بیشتر برای هر حرف در UTF-8 [6] و ادغامهای یادگرفتهی کمتر. اختلاف تا ۱۵ برابر اندازهگیری شده است [5].
- قاعدههای سرانگشتی برای انگلیسی هستند [3]. با توکنساز واقعی بشمارید.
منابع#
- Sennrich, R., Haddow, B., Birch, A. “Neural Machine Translation of Rare Words with Subword Units.” 2015, accepted at ACL 2016. https://arxiv.org/abs/1508.07909
- OpenAI. tiktoken, README (“What is BPE anyway?”). https://github.com/openai/tiktoken
- OpenAI Help Center. “What are tokens and how to count them?” https://help.openai.com/en/articles/4936856-what-are-tokens-and-how-to-count-them
- Kudo, T., Richardson, J. “SentencePiece: A simple and language independent subword tokenizer and detokenizer for Neural Text Processing.” 2018. https://arxiv.org/abs/1808.06226
- Petrov, A., La Malfa, E., Torr, P. H. S., Bibi, A. “Language Model Tokenizers Introduce Unfairness Between Languages.” NeurIPS 2023. https://arxiv.org/abs/2305.15425
- Yergeau, F. “UTF-8, a transformation format of ISO 10646.” RFC 3629, section 3. https://www.rfc-editor.org/rfc/rfc3629
- #ai
- #llm
- #tokenization
- #bpe
- #research
نوشتهی پارسا علیزاده
محصولات وب و موبایل را از صفر تا انتشار میسازم، همراه با ابزارهای هوش مصنوعی که آنها را هوشمندتر میکنند. رابطهای سریع، سیستمهای تمیز و تحویل بهموقع برایم مهم است.