چگونه یک سامانهی RAG را ارزیابی کنیم: معیارهای بازیابی، وفاداری و داوران LLM
بازیابی و تولید را جداگانه بسنجید: recall@k، MRR و nDCG برای بازیاب و وفاداری برای پاسخ؛ و آنچه پژوهشها دربارهی استفاده از مدلهای زبانی بهعنوان داور میگویند.
 پارسا علیزاده
۶ دقیقه مطالعه
در این صفحه
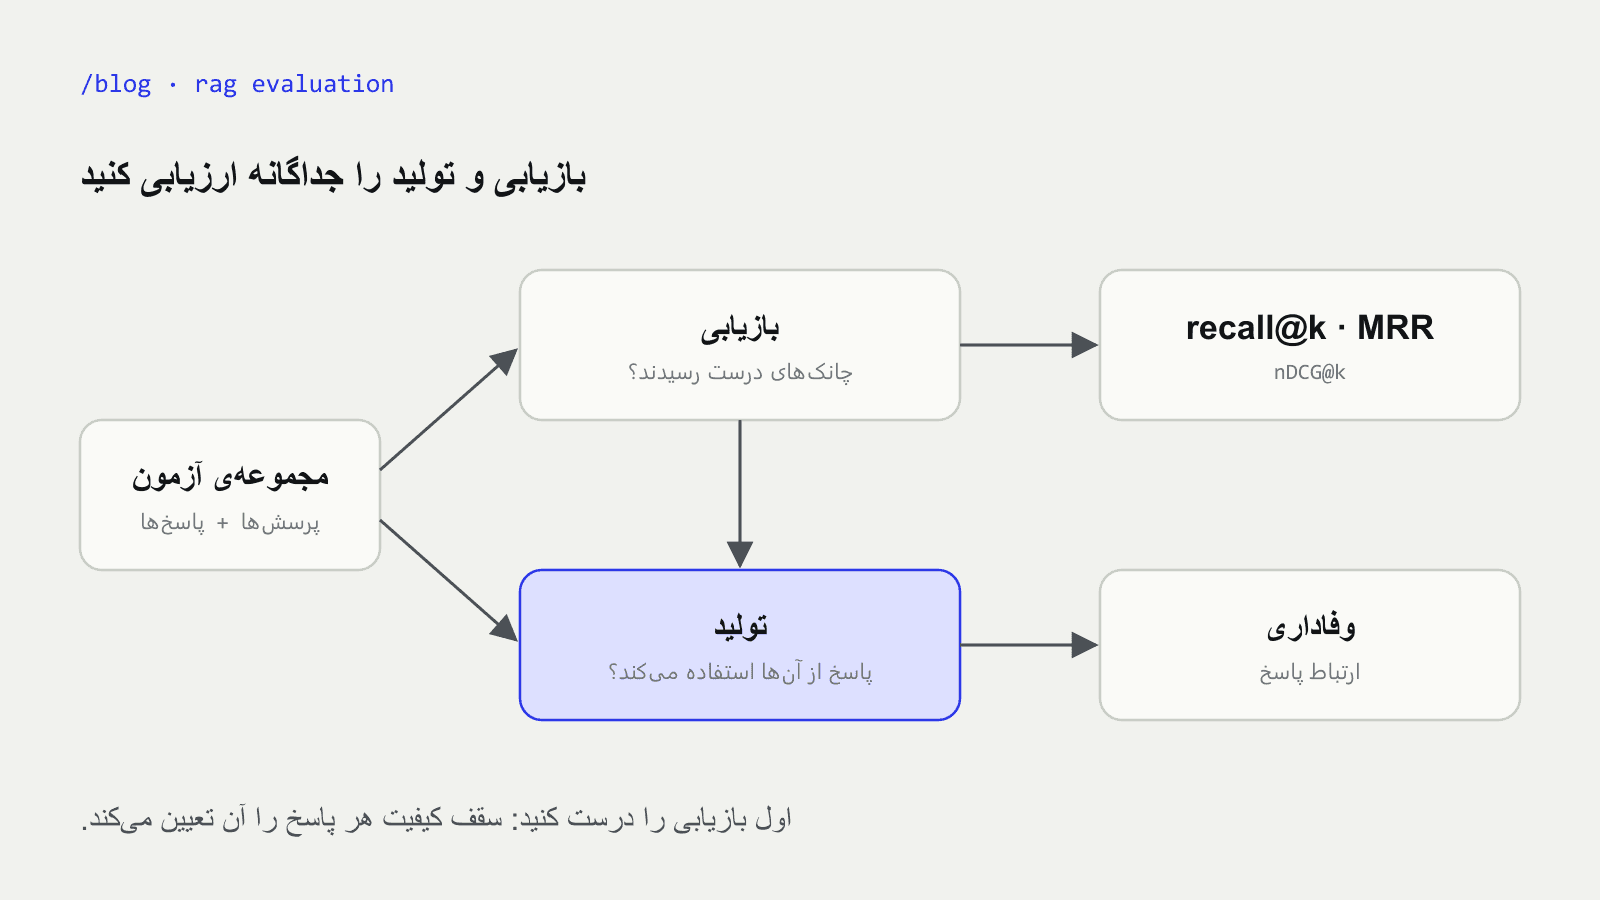
یک سامانهی تولید تقویتشده با بازیابی (retrieval-augmented generation) میتواند در دو جای متفاوت شکست بخورد. ممکن است بازیاب (retriever) بخشی را که پاسخ در آن است پیدا نکند، یا ممکن است مدل زبانی آن بخش را نادیده بگیرد و چیز دیگری بنویسد. یک امتیاز واحد از نوع «آیا پاسخ خوب است؟» نمیتواند این دو را از هم تشخیص دهد، پس نمیتواند به شما بگوید چه چیزی را باید درست کنید. این نوشته ارزیابی را به دو مرحله تقسیم میکند، معیارهای استاندارد بازیابی را در قالب کد نشان میدهد و آنچه پژوهشها دربارهی امتیازدهی خودکار به پاسخها میگویند را خلاصه میکند.
اگر خود این پایپلاین برایتان تازه است، از تولید تقویتشده با بازیابی چگونه کار میکند شروع کنید.
با یک مجموعهی آزمایشی شروع کنید#
همهی معیارهای زیر به یک چیز نیاز دارند: مجموعهای از پرسشها که پاسخ درستشان را از پیش میدانید. برای هر پرسش اینها را یادداشت کنید:
- خود پرسش، با همان عبارتبندیای که کاربران واقعی به کار میبرند.
- چانکهای مرتبط، یعنی شناسههای بخشهایی از نمایهتان که پاسخ را در خود دارند.
- یک پاسخ مرجع، کوتاه، که یک انسان آن را نوشته یا بررسی کرده باشد.
پنجاه تا چند صد پرسش برای مقایسهی دو نسخه از یک پایپلاین کافی است. پرسشهایی را هم بگنجانید که در اسناد شما نباید پاسخی داشته باشند، تا بتوانید بررسی کنید که سامانه بهجای ساختن پاسخ، همین را بگوید.
مرحلهی ۱: بازیابی#
بازیابی یک مسئلهی رتبهبندی (ranking) است، پس با معیارهای بازیابی اطلاعات (information retrieval) سنجیده میشود. هر کدام به پرسشی کمی متفاوت پاسخ میدهد.
- Recall@k: از میان چانکهای مرتبط، چه سهمی در k نتیجهی نخست ظاهر میشوند؟ این معیار برای RAG از همه مهمتر است، چون مدل فقط میتواند از چیزی استفاده کند که به آن داده میشود.
- رتبهی معکوس (reciprocal rank): یک تقسیم بر جایگاه نخستین نتیجهی مرتبط. میانگین آن روی همهی پرسشها، میانگین رتبهی معکوس یا MRR است؛ معیاری که بخش پرسشوپاسخ TREC آن را رایج کرد [1].
- nDCG@k: بهرهی تجمعی تنزیلشدهی نرمالشده (normalised discounted cumulative gain) که Järvelin و Kekäläinen معرفی کردند [2]. این معیار از ارتباط درجهبندیشده (graded relevance) پشتیبانی میکند (یک چانک میتواند تا حدی مرتبط باشد) و قرار دادن بهترین چانکها در صدر را پاداش میدهد.
import math

def recall_at_k(retrieved, relevant, k):
    """Share of the relevant chunk IDs that appear in the top k results."""
    if not relevant:
        return 0.0
    return len(set(retrieved[:k]) & relevant) / len(relevant)

def reciprocal_rank(retrieved, relevant):
    """1 / rank of the first relevant result, or 0 if none was retrieved."""
    for rank, chunk_id in enumerate(retrieved, start=1):
        if chunk_id in relevant:
            return 1 / rank
    return 0.0

def ndcg_at_k(retrieved, relevance, k):
    """relevance maps chunk ID to a graded score, 0 meaning not relevant."""
    dcg = sum(relevance.get(c, 0) / math.log2(i + 2) for i, c in enumerate(retrieved[:k]))
    ideal = sorted(relevance.values(), reverse=True)[:k]
    idcg = sum(r / math.log2(i + 2) for i, r in enumerate(ideal))
    return dcg / idcg if idcg else 0.0

# One question: the retriever returned these chunk IDs, in order.
retrieved = ["c7", "c2", "c9", "c4", "c1"]
relevant = {"c2", "c4"}

print(recall_at_k(retrieved, relevant, k=3))  # 0.5: only c2 is in the top 3
print(reciprocal_rank(retrieved, relevant))   # 0.5: first hit at rank 2
print(ndcg_at_k(retrieved, {"c2": 2, "c4": 1}, k=5))
تنزیل log2(i + 2) همان شکلی است که امروز بیشتر کتابخانهها به کار میبرند. مقالهی اصلی تنزیل را کمی متفاوت تعریف میکند، اما ایده یکی است: نتیجهی مرتبطی که پایینتر در فهرست باشد ارزش کمتری دارد [2].
این معیارها را روی کل مجموعهی آزمایشی اجرا کنید و میانگین بگیرید. سپس هر بار فقط یک چیز را تغییر دهید (اندازهی چانک، مدل تعبیه، تعداد نتایج، یک بازرتبهساز یا reranker) و مقایسه کنید. چون معیارهای بازیابی به هیچ مدل زبانی نیاز ندارند، کمهزینه و کاملاً تکرارپذیرند.
مرحلهی ۲: تولید#
وقتی چانکهای درست به مدل رسیدند، پرسش این میشود که آیا پاسخ از آنها استفاده میکند یا نه. دو ویژگی از همه مهمترند:
- وفاداری (faithfulness): هر ادعای پاسخ با زمینهی بازیابیشده پشتیبانی میشود. پاسخ غیروفادار یک توهم (hallucination) است، حتی اگر از قضا درست باشد.
- مرتبط بودن پاسخ (answer relevance): پاسخ به همان پرسشی میپردازد که پرسیده شده، نه به چیزی در همان حوالی.
RAGAS، کار Shahul Es و همکارانش، نسخههای خودکار هر دو را پیشنهاد میکند و یک معیار سوم هم برای زمینه میافزاید [3]:
- وفاداری: یک مدل زبانی پاسخ را به گزارههای جداگانه تقسیم میکند و هر کدام را با زمینه میسنجد. امتیاز، سهم گزارههایی است که پشتیبانی میشوند [3].
- مرتبط بودن پاسخ: یک مدل زبانی پرسشهایی تولید میکند که پاسخ با آنها جور باشد، و امتیاز، شباهت تعبیهای این پرسشها با پرسش اصلی است [3].
- مرتبط بودن زمینه (context relevance): سهم جملههایی از زمینهی بازیابیشده که واقعاً برای پاسخ دادن به پرسش لازماند؛ این معیار بازیابی حجم زیادی نویز را جریمه میکند [3].
این امتیازها به پاسخ مرجع نیازی ندارند و همین آنها را برای پایش ترافیک واقعی مفید میکند. با داشتن مجموعهی آزمایشی، میتوانید پاسخ را مستقیماً با پاسخ مرجع هم مقایسه کنید.
آیا یک مدل زبانی میتواند داور باشد؟#
بررسیهای وفاداری و مرتبط بودن به این وابستهاند که یک مدل زبانی به متن نمره بدهد. Lianmin Zheng و همکارانش این موضوع را در «Judging LLM-as-a-Judge» بررسی کردند [4]. آنها دریافتند که GPT-4 در نقش داور در بیش از ۸۰٪ موارد با ترجیحات انسانی همنظر بود، تقریباً به همان میزانی که داوران انسانی با یکدیگر همنظر بودند [4].
آنها همچنین سوگیریهایی را ثبت کردند که باید در طراحی به آنها توجه کرد [4]:
- سوگیری جایگاه (position bias): ترجیح یک پاسخ به خاطر جایی که قرار گرفته، مثلاً پاسخ اول از میان دو پاسخ.
- سوگیری پرگویی (verbosity bias): ترجیح پاسخهای طولانیتر، حتی وقتی بهتر نیستند.
- سوگیری خودبرتربینی (self-enhancement bias): ترجیح پاسخهایی که همان مدل نوشته است.
راهکارهای عملی از همین فهرست به دست میآیند: هنگام مقایسهی دو پاسخ ترتیبشان را جابهجا کنید و فقط حکمهای سازگار را نگه دارید، بهجای نظر آزاد، امتیازی بر اساس یک دستورالعمل امتیازدهی (rubric) مکتوب بخواهید، و از مدلی که در حال آزمایش است بهعنوان داور خودش استفاده نکنید.
ARES، کار Jon Saad-Falcon و همکارانش، گامی برای اعتماد به اعداد اضافه میکند [5]. این چارچوب مدلهای داور سبکی را برای مرتبط بودن زمینه، وفاداری و مرتبط بودن پاسخ آموزش میدهد، سپس با مجموعهی کوچکی از نمونههای برچسبخورده به دست انسان، خطاهای داوران را تصحیح میکند و برای نتایج بازههای اطمینان (confidence intervals) تعیین میکند؛ روشی که استنتاج مبتنی بر پیشبینی (prediction-powered inference) نام دارد [5].
یک روال کاری عملی#
- یک مجموعهی آزمایشی با پرسشها، شناسههای چانکهای مرتبط و پاسخهای مرجع بسازید.
- بازیابی را با recall@k، MRR و nDCG بسنجید. اول بازیابی را درست کنید، چون سقف کار را تعیین میکند.
- تولید را با وفاداری و مرتبط بودن پاسخ بسنجید، با داوری که آن را با برچسبهای انسانی محک زدهاید.
- هر بار فقط یک جزء را تغییر دهید و همه چیز را دوباره اجرا کنید.
- مجموعهی آزمایشی را زیر کنترل نسخه (version control) نگه دارید و هر شکست واقعیای را که پیدا میکنید به آن اضافه کنید.
جمعبندی#
- بازیابی و تولید را جداگانه ارزیابی کنید، وگرنه نمیتوانید بگویید کدام یک شکست خورده است.
- Recall@k، MRR [1] و nDCG [2] بازیاب را بدون هیچ مدل زبانی میسنجند.
- وفاداری، مرتبط بودن پاسخ و مرتبط بودن زمینه را میتوان بهطور خودکار امتیازدهی کرد، همانطور که در RAGAS [3] انجام میشود.
- داوران LLM اغلب با انسانها همنظرند، اما سوگیریهای شناختهشدهای دارند [4]؛ آنها را با برچسبهای انسانی واسنجی کنید [5].
منابع#
- Voorhees, E. M. “The TREC-8 Question Answering Track Report.” TREC 1999. https://trec.nist.gov/pubs/trec8/papers/qa_report.pdf
- Järvelin, K., Kekäläinen, J. “Cumulated gain-based evaluation of IR techniques.” ACM Transactions on Information Systems 20(4), 2002. https://doi.org/10.1145/582415.582418
- Es, S., James, J., Espinosa-Anke, L., Schockaert, S. “RAGAS: Automated Evaluation of Retrieval Augmented Generation.” 2023. https://arxiv.org/abs/2309.15217
- Zheng, L., Chiang, W.-L., Sheng, Y., Zhuang, S., Wu, Z., Zhuang, Y., Lin, Z., Li, Z., Li, D., Xing, E. P., Zhang, H., Gonzalez, J. E., Stoica, I. “Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena.” NeurIPS 2023. https://arxiv.org/abs/2306.05685
- Saad-Falcon, J., Khattab, O., Potts, C., Zaharia, M. “ARES: An Automated Evaluation Framework for Retrieval-Augmented Generation Systems.” 2023. https://arxiv.org/abs/2311.09476
- #ai
- #llm
- #rag
- #evaluation
- #research
نوشتهی پارسا علیزاده
محصولات وب و موبایل را از صفر تا انتشار میسازم، همراه با ابزارهای هوش مصنوعی که آنها را هوشمندتر میکنند. رابطهای سریع، سیستمهای تمیز و تحویل بهموقع برایم مهم است.