جستوجوی برداری چگونه همسایهها را سریع پیدا میکند: تعبیهها، شباهت و HNSW
چرا جستوجوی دقیق نزدیکترین همسایه مقیاسپذیر نیست، جستوجوی تقریبی چه چیزی را فدا میکند، و گراف HNSW از مقالهی Malkov و Yashunin چگونه بردارهای نزدیک را سریع پیدا میکند.
 پارسا علیزاده
۴ دقیقه مطالعه
در این صفحه
در قلب هر سامانهی هوش مصنوعی مبتنی بر بازیابی یک پرسش یکسان نشسته است: با داشتن یک بردار پرسش، کدام بردارهای ذخیرهشده به آن نزدیکترند؟ پاسخ دادن سریع به این پرسش، آن هم در میان میلیونها بردار، کار نمایهی برداری (vector index) است. این نوشته مسئله را توضیح میدهد و یکی از پرکاربردترین راهحلهای آن را معرفی میکند: گراف سلسلهمراتبی دنیای کوچک پیمایشپذیر (Hierarchical Navigable Small World) یا HNSW.
تعبیهها و شباهت#
یک تعبیه (embedding) فهرستی از اعداد، یعنی یک بردار، است که یک تکه متن، یک تصویر یا چیز دیگری را نمایش میدهد. مدلهای تعبیه طوری آموزش میبینند که بردار چیزهایی که معنای مشابهی دارند به هم نزدیک باشد.
«نزدیک» نیاز به تعریف دارد. یکی از تعریفهای رایج شباهت کسینوسی (cosine similarity) است، یعنی کسینوس زاویهی میان دو بردار:
cosine(a, b) = (a · b) / (‖a‖ · ‖b‖)مقدار آن از منفی ۱ تا ۱ است و وقتی دو بردار در یک جهت باشند برابر ۱ میشود. برای بردارهایی که به طول ۱ نرمالسازی شدهاند، شباهت کسینوسی با ضرب نقطهای برابر است؛ به همین دلیل بسیاری از سامانهها تعبیهها را یک بار نرمالسازی میکنند و سپس با ضرب نقطهای مقایسهشان میکنند.
چرا جستوجوی دقیق مقیاسپذیر نیست#
محاسبهی پاسخ دقیق ساده است: پرسش را با تکتک بردارهای ذخیرهشده مقایسه کنید و بهترین را نگه دارید. این کار برای هر پرسش به ازای هر بردار ذخیرهشده یک مقایسه هزینه دارد، پس حجم کار بهطور خطی با اندازهی مجموعه رشد میکند. وقتی با میلیونها بردار و تعداد زیادی پرسش در ثانیه سروکار داریم، همین به گلوگاه تبدیل میشود.
جستوجوی نزدیکترین همسایهی تقریبی (approximate nearest neighbour) یا ANN یک بدهبستان را میپذیرد: ممکن است گاهی یک نزدیکترین همسایهی واقعی را از دست بدهد، در عوض بسیار سریعتر پاسخ میدهد. کیفیت این بدهبستان معمولاً با فراخوانی (recall) گزارش میشود، یعنی سهمی از نزدیکترین همسایههای واقعی که نمایه واقعاً برمیگرداند.
HNSW از دل مقاله#
HNSW را Yu. A. Malkov و D. A. Yashunin در مقالهی «Efficient and robust approximate nearest neighbor search using Hierarchical Navigable Small World graphs» معرفی کردند که نخستین بار در ۳۰ مارس ۲۰۱۶ منتشر شد [1].
مقاله آن را ساختاری چندلایه توصیف میکند که از مجموعهای سلسلهمراتبی از گرافهای مجاورت (proximity graphs) تشکیل شده است؛ برای هر لایه یک گراف، روی زیرمجموعههای تودرتو از عناصر ذخیرهشده [1]. دو ایده آن را کارآمد میکند.
۱. لایههای تصادفی، مانند فهرست پرشی#
وقتی عنصری درج میشود، بالاترین لایهای که در آن حضور دارد بهطور تصادفی و با یک توزیع احتمال نمایی نزولی انتخاب میشود [1]. بیشتر عناصر فقط در لایهی پایینی هستند و تنها تعداد کمی به لایههای بالاتر و کمتراکمتر میرسند.
نویسندگان این شباهت را صریحاً بیان میکنند: HNSW را «میتوان گسترشی از ساختار احتمالاتی فهرست پرشی (skip list) دانست که در آن بهجای فهرستهای پیوندی از گرافهای مجاورت استفاده شده است» [2].
۲. جستوجو از بالا به پایین#
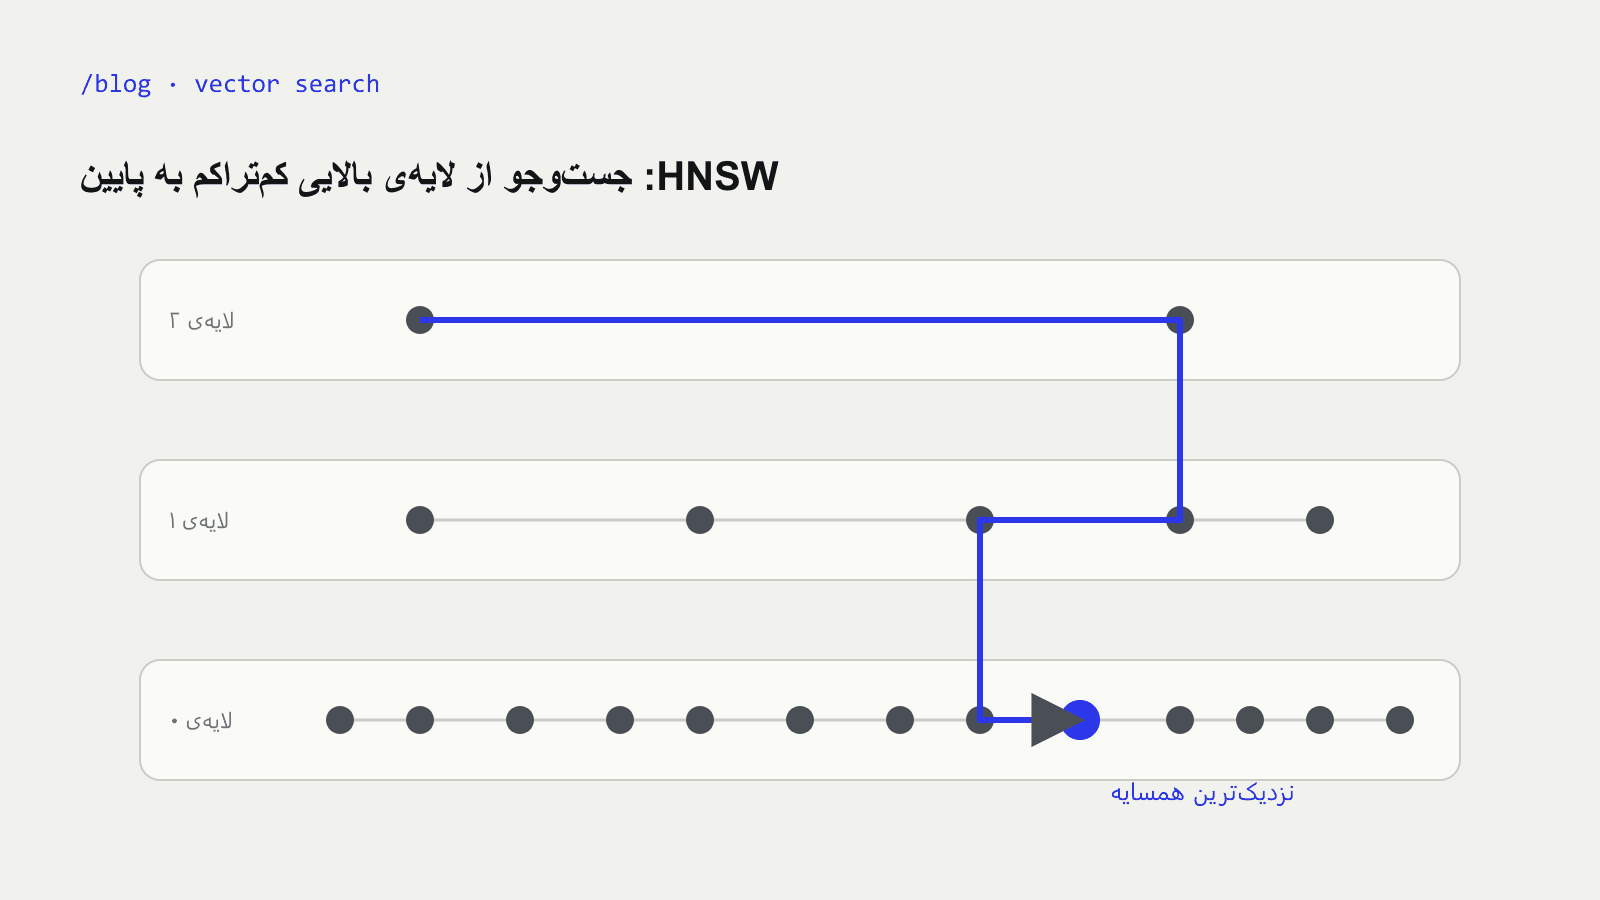
جستوجو از لایهی بالایی آغاز میشود [1]. در آنجا پیوندها بلندند، پس یک پیمایش حریصانه (greedy) مسافتهای زیادی را سریع طی میکند. وقتی دیگر نتواند نزدیکتر شود، یک لایه پایین میآید و با پیوندهای کوتاهتر ادامه میدهد تا به لایهی پایینی برسد که همهی عناصر را در خود دارد. مقاله گزارش میدهد که شروع از لایهی بالایی همراه با این تفکیک مقیاس، پیچیدگیای با رشد لگاریتمی را ممکن میکند [1].
پارامترهایی که با آنها روبهرو میشوید#
کتابخانههایی که HNSW را پیادهسازی میکنند پارامترهایی را در اختیار میگذارند که در الگوریتم درج مقاله نامگذاری شدهاند [2]:
| پارامتر | معنا در مقاله |
|---|---|
M | تعداد اتصالهایی که برای هر عنصر جدید برقرار میشود |
Mmax | بیشینهی تعداد اتصالهای هر عنصر در هر لایه |
efConstruction | اندازهی فهرست پویای نامزدها هنگام ساختن نمایه |
ef | اندازهی فهرست پویای نامزدها هنگام جستوجو؛ کیفیت جستوجو را کنترل میکند |
mL | ضریب نرمالسازی برای انتخاب بالاترین لایهی هر عنصر |
برای mL، مقاله انتخابی ساده پیشنهاد میکند: 1 / ln(M) [2]. کیفیت جستوجو با ef کنترل میشود [2]: فهرست نامزدهای بزرگتر بخش بیشتری از گراف را میکاود، که معمولاً فراخوانی را بالا میبرد و زمان بیشتری میگیرد. به همین دلیل این مقادیر معمولاً بر اساس یک هدف فراخوانی تنظیم میشوند، نه اینکه یک بار تعیین شوند و رها شوند.
جایگاه آن در کل ماجرا#
جستوجوی برداری همان گام «بازیابی» در تولید تقویتشده با بازیابی است. اگر نمایه بخش درست را از دست بدهد، مدل زبانی هرگز آن را نمیبیند. بقیهی این پایپلاین را در تولید تقویتشده با بازیابی و سمت مدل را در ترنسفورمر از دل مقالهی اصلی پوشش دادهام.
جمعبندی#
- تعبیهها چیزها را به بردار تبدیل میکنند؛ شباهت، که اغلب کسینوسی است، میزان نزدیکی را میسنجد.
- جستوجوی دقیق با همهی بردارها مقایسه میکند، پس هزینهاش بهطور خطی با اندازهی مجموعه رشد میکند.
- HNSW گرافهای مجاورت لایهلایه با لایههای تصادفی، شبیه فهرست پرشی، میسازد و از لایهی بالایی و کمتراکم به پایین جستوجو میکند [1][2].
efکیفیت جستوجو را کنترل میکند؛ آن را همراه باMوefConstructionبر اساس یک هدف فراخوانی تنظیم کنید [2].
منابع#
- Malkov, Yu. A., Yashunin, D. A. “Efficient and robust approximate nearest neighbor search using Hierarchical Navigable Small World graphs.” 2016. Abstract: https://arxiv.org/abs/1603.09320
- The same paper, full text (sections on the algorithm and Algorithm 1): https://arxiv.org/pdf/1603.09320
- #ai
- #vector-search
- #hnsw
- #embeddings
- #research
نوشتهی پارسا علیزاده
محصولات وب و موبایل را از صفر تا انتشار میسازم، همراه با ابزارهای هوش مصنوعی که آنها را هوشمندتر میکنند. رابطهای سریع، سیستمهای تمیز و تحویل بهموقع برایم مهم است.