Bir RAG sistemi nasıl değerlendirilir: erişim metrikleri, sadakat ve LLM hakemler
Erişimi ve üretimi ayrı ayrı ölçün: erişici için recall@k, MRR ve nDCG, cevap için sadakat; ayrıca dil modellerinin hakem olarak kullanılması hakkında araştırmaların söyledikleri.
 Parsa Alizadeh
5 dk okuma
Bu sayfada
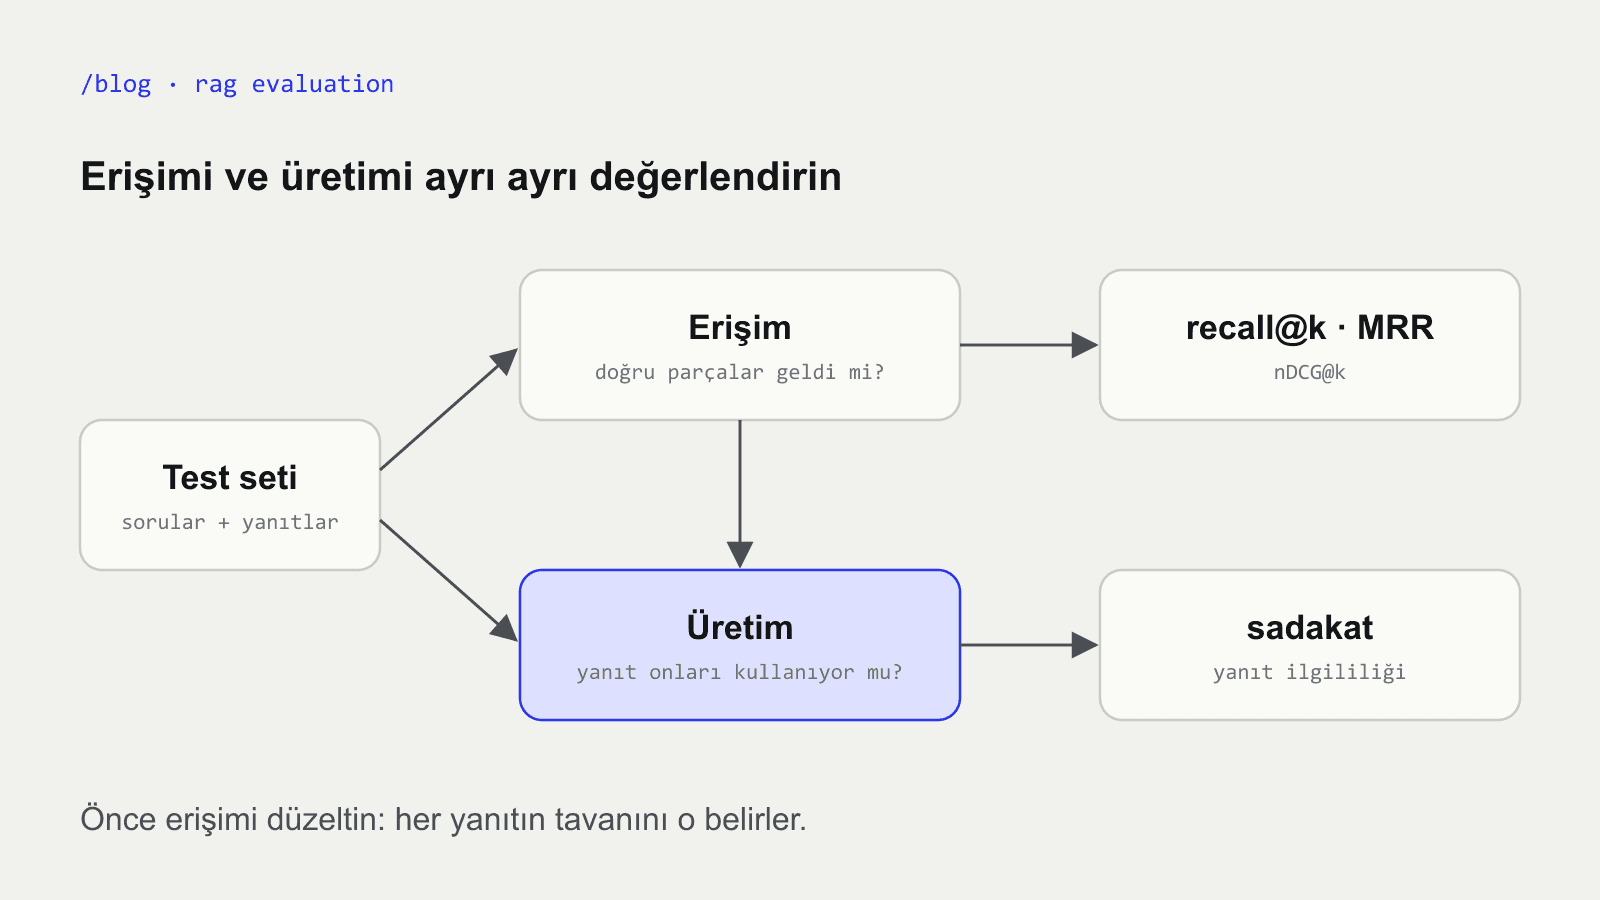
Erişimle zenginleştirilmiş bir üretim sistemi iki farklı yerde başarısız olabilir. Erişici, cevabı içeren pasajı kaçırabilir ya da dil modeli o pasajı görmezden gelip başka bir şey yazabilir. Tek bir “cevap iyi mi?” puanı bu ikisini birbirinden ayıramaz; dolayısıyla neyi düzeltmeniz gerektiğini de söyleyemez. Bu yazı değerlendirmeyi iki aşamaya ayırıyor, standart erişim metriklerini kodla gösteriyor ve cevapların otomatik olarak puanlanması konusunda araştırmaların söylediklerini özetliyor.
İşlem hattının kendisi sizin için yeniyse erişimle zenginleştirilmiş üretimin nasıl çalıştığı yazısıyla başlayın.
Bir test kümesiyle başlayın#
Aşağıdaki her metrik aynı şeye ihtiyaç duyar: doğru cevabını önceden bildiğiniz bir soru kümesi. Her soru için şunları not edin:
- Soru, gerçek kullanıcıların sorduğu biçimde ifade edilmiş olarak.
- İlgili parçalar, yani dizininizde cevabı içeren pasajların kimlikleri (ID).
- Bir referans cevap, kısa ve bir insan tarafından yazılmış ya da kontrol edilmiş.
Bir işlem hattının iki sürümünü karşılaştırmak için elli ile birkaç yüz arasında soru yeterlidir. Belgelerinizde cevabı olmaması gereken soruları da ekleyin; böylece sistemin bir cevap uydurmak yerine bunu söyleyip söylemediğini kontrol edebilirsiniz.
1. aşama: erişim#
Erişim bir sıralama problemidir; bu yüzden bilgi erişimi (information retrieval) metrikleriyle ölçülür. Her metrik biraz farklı bir soruyu cevaplar.
- Recall@k: ilgili parçaların ne kadarı ilk k sonuç içinde yer alıyor? RAG için en önemli metrik budur, çünkü model yalnızca kendisine verileni kullanabilir.
- Karşılıklı sıra (reciprocal rank): bir bölü ilk ilgili sonucun sırası. Tüm sorular üzerinden ortalaması alındığında, TREC soru cevaplama kulvarıyla (track) yaygınlaşan bir metrik olan ortalama karşılıklı sıra, yani MRR elde edilir [1].
- nDCG@k: Järvelin ve Kekäläinen tarafından tanıtılan normalize edilmiş indirgenmiş kümülatif kazanç (normalised discounted cumulative gain) [2]. Dereceli ilgililiği destekler (bir parça kısmen ilgili olabilir) ve en iyi parçaları başa koymayı ödüllendirir.
import math

def recall_at_k(retrieved, relevant, k):
    """Share of the relevant chunk IDs that appear in the top k results."""
    if not relevant:
        return 0.0
    return len(set(retrieved[:k]) & relevant) / len(relevant)

def reciprocal_rank(retrieved, relevant):
    """1 / rank of the first relevant result, or 0 if none was retrieved."""
    for rank, chunk_id in enumerate(retrieved, start=1):
        if chunk_id in relevant:
            return 1 / rank
    return 0.0

def ndcg_at_k(retrieved, relevance, k):
    """relevance maps chunk ID to a graded score, 0 meaning not relevant."""
    dcg = sum(relevance.get(c, 0) / math.log2(i + 2) for i, c in enumerate(retrieved[:k]))
    ideal = sorted(relevance.values(), reverse=True)[:k]
    idcg = sum(r / math.log2(i + 2) for i, r in enumerate(ideal))
    return dcg / idcg if idcg else 0.0

# One question: the retriever returned these chunk IDs, in order.
retrieved = ["c7", "c2", "c9", "c4", "c1"]
relevant = {"c2", "c4"}

print(recall_at_k(retrieved, relevant, k=3))  # 0.5: only c2 is in the top 3
print(reciprocal_rank(retrieved, relevant))   # 0.5: first hit at rank 2
print(ndcg_at_k(retrieved, {"c2": 2, "c4": 1}, k=5))
log2(i + 2) indirgemesi, bugün çoğu kütüphanenin kullandığı biçimdir. Orijinal makale indirgemeyi biraz farklı tanımlar, ancak fikir aynıdır: listede daha aşağıda yer alan ilgili bir sonuç daha az değerlidir [2].
Bu metrikleri tüm test kümesi üzerinde çalıştırıp ortalamalarını alın. Ardından her seferinde tek bir şeyi değiştirin (parça boyutu, gömme modeli, sonuç sayısı, yeniden sıralayıcı) ve karşılaştırın. Erişim metrikleri dil modeline ihtiyaç duymadığı için ucuzdur ve tamamen tekrarlanabilir.
2. aşama: üretim#
Doğru parçalar modele ulaştıktan sonra soru, cevabın bunları kullanıp kullanmadığına dönüşür. En önemli iki özellik şunlardır:
- Sadakat (faithfulness): cevaptaki her iddia, erişilen bağlam tarafından desteklenir. Sadık olmayan bir cevap, tesadüfen doğru olsa bile bir halüsinasyondur.
- Cevap ilgililiği (answer relevance): cevap, yakın bir konuyu değil, sorulan soruyu ele alır.
Shahul Es ve arkadaşlarının geliştirdiği RAGAS, her ikisinin otomatik sürümlerini ve bunlara ek olarak bağlam için üçüncü bir metrik önerir [3]:
- Sadakat: bir dil modeli cevabı tek tek ifadelere ayırır ve her birini bağlamla karşılaştırır. Puan, desteklenen ifadelerin oranıdır [3].
- Cevap ilgililiği: bir dil modeli, cevabın uyacağı sorular üretir; puan, bu soruların orijinal soruyla gömme benzerliğidir [3].
- Bağlam ilgililiği: erişilen bağlamdaki cümlelerden soruyu cevaplamak için gerçekten gerekli olanların oranı; bu metrik çok fazla gürültü getirmeyi cezalandırır [3].
Bu puanlar referans cevaba ihtiyaç duymaz, bu da onları gerçek trafiği izlemek için kullanışlı kılar. Bir test kümeniz varsa cevabı doğrudan referans cevapla da karşılaştırabilirsiniz.
Bir dil modeli hakem olabilir mi?#
Sadakat ve ilgililik kontrolleri, metni bir dil modelinin puanlamasına dayanır. Lianmin Zheng ve arkadaşları bunu “Judging LLM-as-a-Judge” çalışmasında inceledi [4]. Hakem olarak kullanılan GPT-4’ün insan tercihleriyle zamanın %80’inden fazlasında uyuştuğunu buldular; bu, insan hakemlerin birbiriyle uyuşma oranıyla hemen hemen aynıdır [4].
Ayrıca tasarım yaparken hesaba katılması gereken önyargıları da belgelediler [4]:
- Konum önyargısı: bir cevabı bulunduğu yer nedeniyle, örneğin iki cevaptan ilki olduğu için tercih etmek.
- Uzunluk önyargısı (verbosity bias): daha iyi olmasalar bile daha uzun cevapları tercih etmek.
- Kendini kayırma önyargısı (self-enhancement bias): aynı model tarafından yazılmış cevapları tercih etmek.
Pratik önlemler bu listeden çıkar: iki cevabı karşılaştırırken sıralarını değiştirin ve yalnızca tutarlı kararları tutun, serbest bir görüş yerine yazılı bir değerlendirme ölçütüne (rubric) göre puan isteyin ve test edilen modeli kendi hakemi olarak kullanmaktan kaçının.
Jon Saad-Falcon ve arkadaşlarının geliştirdiği ARES, sayılara güvenebilmek için bir adım ekler [5]. Bağlam ilgililiği, sadakat ve cevap ilgililiği için hafif hakem modelleri eğitir; ardından hakemlerin hatalarını düzeltmek ve sonuçlara güven aralıkları koymak için insanlar tarafından etiketlenmiş küçük bir örnek kümesi kullanır. Bu tekniğe tahmin destekli çıkarım (prediction-powered inference) denir [5].
Uygulanabilir bir rutin#
- Sorular, ilgili parça kimlikleri ve referans cevaplardan oluşan bir test kümesi oluşturun.
- Erişimi recall@k, MRR ve nDCG ile ölçün. Tavanı erişim belirlediği için önce erişimi düzeltin.
- Üretimi, insan etiketleriyle karşılaştırarak doğruladığınız bir hakem kullanarak sadakat ve cevap ilgililiğiyle ölçün.
- Her seferinde tek bir bileşeni değiştirin ve her şeyi yeniden çalıştırın.
- Test kümesini sürüm kontrolü altında tutun ve bulduğunuz her gerçek hatayı ona ekleyin.
Özet#
- Erişimi ve üretimi ayrı ayrı değerlendirin; aksi takdirde hangisinin başarısız olduğunu anlayamazsınız.
- Recall@k, MRR [1] ve nDCG [2], erişiciyi herhangi bir dil modeli olmadan ölçer.
- Sadakat, cevap ilgililiği ve bağlam ilgililiği, RAGAS’ta olduğu gibi otomatik olarak puanlanabilir [3].
- LLM hakemler insanlarla çoğu zaman uyuşur, ancak bilinen önyargıları vardır [4]; onları insan etiketleriyle kalibre edin [5].
Kaynaklar#
- Voorhees, E. M. “The TREC-8 Question Answering Track Report.” TREC 1999. https://trec.nist.gov/pubs/trec8/papers/qa_report.pdf
- Järvelin, K., Kekäläinen, J. “Cumulated gain-based evaluation of IR techniques.” ACM Transactions on Information Systems 20(4), 2002. https://doi.org/10.1145/582415.582418
- Es, S., James, J., Espinosa-Anke, L., Schockaert, S. “RAGAS: Automated Evaluation of Retrieval Augmented Generation.” 2023. https://arxiv.org/abs/2309.15217
- Zheng, L., Chiang, W.-L., Sheng, Y., Zhuang, S., Wu, Z., Zhuang, Y., Lin, Z., Li, Z., Li, D., Xing, E. P., Zhang, H., Gonzalez, J. E., Stoica, I. “Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena.” NeurIPS 2023. https://arxiv.org/abs/2306.05685
- Saad-Falcon, J., Khattab, O., Potts, C., Zaharia, M. “ARES: An Automated Evaluation Framework for Retrieval-Augmented Generation Systems.” 2023. https://arxiv.org/abs/2311.09476
- #ai
- #llm
- #rag
- #evaluation
- #research
Yazan: Parsa Alizadeh
Web ve mobil ürünleri baştan sona geliştiriyorum; onları daha akıllı hale getiren yapay zekâ araçlarıyla birlikte. Hızlı arayüzler, temiz sistemler ve işi teslim etmek benim için önemli.