ترنسفورمر از دل مقالهی اصلی: توضیح مکانیزم توجه برای توسعهدهندگان
توجه ضرب نقطهای مقیاسشده، توجه چندسَر و کدگذاری موقعیتی چگونه کار میکنند؛ با فرمولها و تنظیماتی که مستقیماً از مقالهی «Attention Is All You Need» گرفته شدهاند.
 پارسا علیزاده
۳ دقیقه مطالعه
در این صفحه
بیشتر مدلهای زبانی بزرگی که امروز به کار میروند بر یک معماری استوارند: ترنسفورمر (Transformer). این معماری در مقالهای در سال ۲۰۱۷ معرفی شد که کوتاه و دقیق است و هنوز هم بهترین جا برای فهمیدن طرز کار آن به شمار میرود. این نوشته سازوکار محوری آن، یعنی توجه (attention)، را با فرمولها و اعداد خود مقاله مرور میکند.
مقاله#
مقالهی «Attention Is All You Need» را Ashish Vaswani، Noam Shazeer، Niki Parmar، Jakob Uszkoreit، Llion Jones، Aidan N. Gomez، Łukasz Kaiser و Illia Polosukhin نوشتهاند و نخستین بار در ۱۲ ژوئن ۲۰۱۷ منتشر شد [1].
ادعای محوری آن در چکیده آمده است: ترنسفورمر تنها بر سازوکارهای توجه بنا شده و بازگشت (recurrence) و کانولوشن (convolution) را بهکلی کنار گذاشته است [1]. پیش از آن، مدلهای پیشروی پردازش دنباله متن را گام به گام و با شبکههای بازگشتی پردازش میکردند. توجه به هر موقعیت اجازه میدهد مستقیماً به همهی موقعیتهای دیگر نگاه کند.
توجه ضرب نقطهای مقیاسشده#
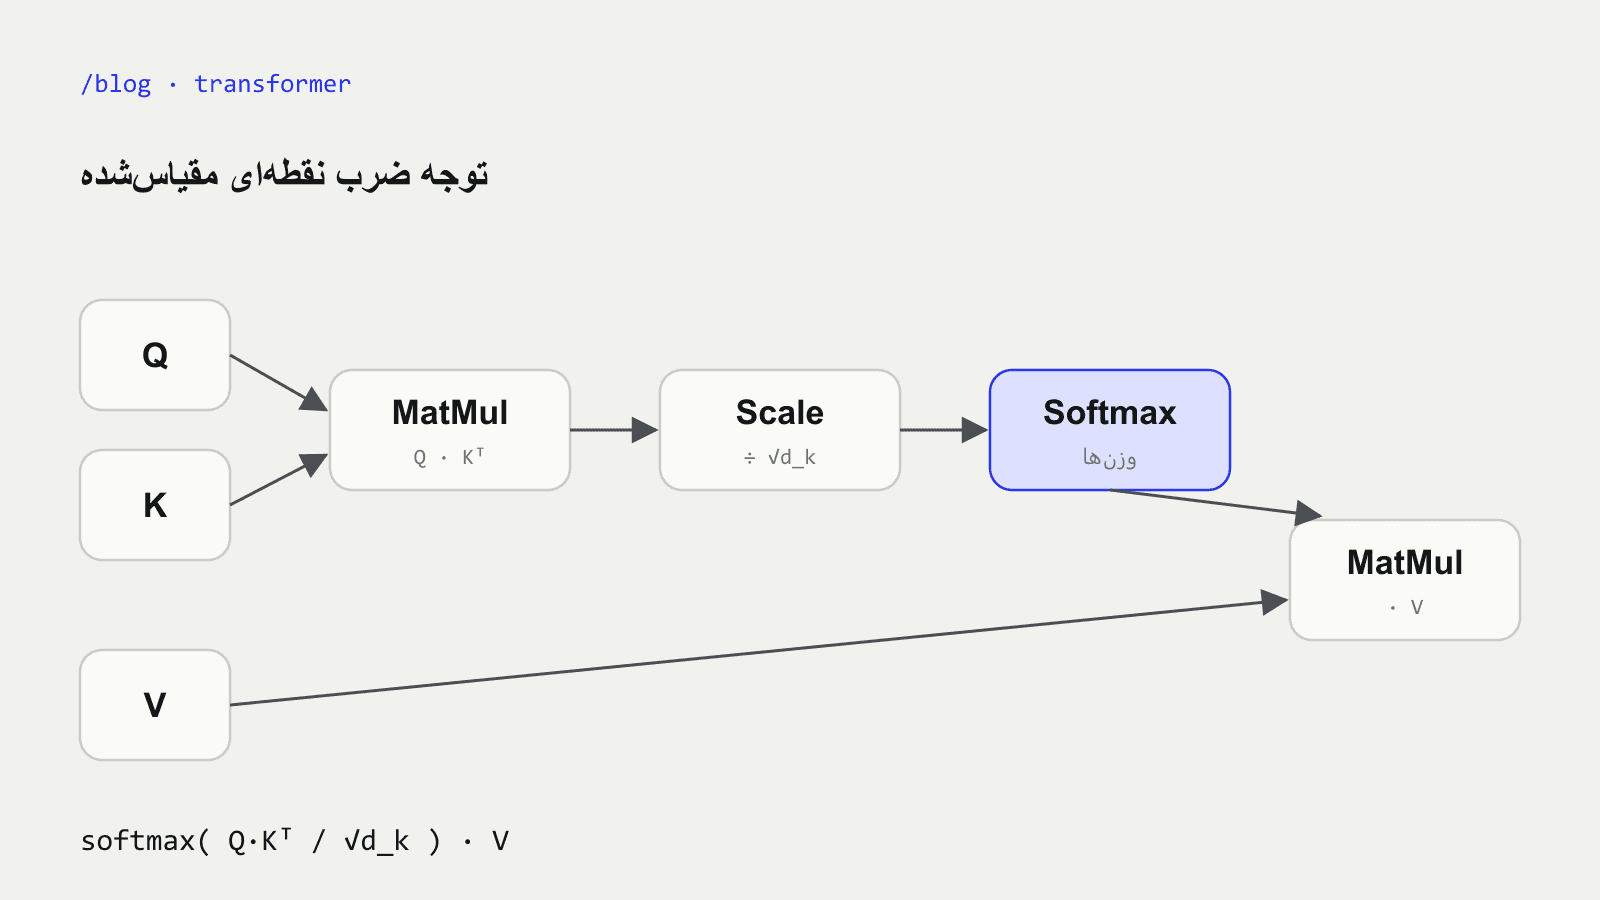
توجه سه ماتریس میگیرد: کوئریها (queries) Q، کلیدها (keys) K و مقدارها (values) V. مقاله آن را اینگونه تعریف میکند [2]:
Attention(Q, K, V) = softmax( Q·Kᵀ / √d_k ) · Vآن را از درون به بیرون بخوانید:
- Q·Kᵀ با ضرب نقطهای میسنجد که هر کوئری چقدر با هر کلید جور است.
- ÷ √d_k امتیازها را مقیاس میکند؛
d_kبُعد کلیدهاست. - softmax هر سطر از امتیازها را به وزنهایی تبدیل میکند که مثبتاند و جمعشان ۱ میشود.
- · V با این وزنها میانگین وزنی مقدارها را میگیرد.
چرا تقسیم بر √d_k#
مقاله توضیح میدهد که وقتی d_k بزرگ است، اندازهی ضربهای نقطهای بزرگ میشود و softmax را به نواحیای میراند که گرادیانهایش بسیار کوچکاند [2]. اگر مؤلفههای کوئریها و کلیدها مستقل و با میانگین ۰ و واریانس ۱ باشند، ضرب نقطهای آنها میانگین ۰ و واریانس d_k دارد [2]. تقسیم بر √d_k واریانس را به ۱ برمیگرداند و همین آموزش را پایدار نگه میدارد.
توجه چندسَر#
یک تابع توجه ورودی را تنها از یک زاویه میبیند. توجه چندسَر (multi-head attention) چند تابع توجه را بهموازات اجرا میکند، هر یک با تصویرهای (projections) آموختهشدهی خودش، و نتایج را به هم الحاق میکند [2]:
MultiHead(Q, K, V) = Concat(head₁, …, head_h) · Wᴼ
where headᵢ = Attention(Q·Wᵢᵠ, K·Wᵢᴷ, V·Wᵢⱽ)
مدل پایهی مقاله از h = 8 سر استفاده میکند، با d_model = 512 و d_k = d_v = d_model / h = 64 [2]. چون هر سر در بُعدی کوچکتر کار میکند، هزینهی کل تقریباً برابر با یک سر واحد با ابعاد کامل است [2].
کدگذاری موقعیتی#
توجه بهتنهایی درکی از ترتیب ندارد و ورودی را مثل یک مجموعه میبیند. مقاله به هر تعبیهی ورودی یک کدگذاری موقعیتی (positional encoding) اضافه میکند که از توابع سینوس و کسینوس با بسامدهای مختلف ساخته میشود [2]:
PE(pos, 2i)   = sin( pos / 10000^(2i / d_model) )
PE(pos, 2i+1) = cos( pos / 10000^(2i / d_model) )
در اینجا pos موقعیت در دنباله و i شمارهی بُعد است.
مدل کامل، به زبان اعداد#
- رمزگذار (encoder) و رمزگشا (decoder) هر کدام پشتهای از N = 6 لایهی یکساناند [2].
- در وظیفهی ترجمهی انگلیسی به آلمانی WMT 2014، مدل به ۲۸٫۴ BLEU رسید و در انگلیسی به فرانسوی به ۴۱٫۸ BLEU [1].
- نتیجهی ۴۱٫۸ BLEU در ترجمهی انگلیسی به فرانسوی پس از ۳٫۵ روز آموزش روی هشت GPU به دست آمد [1].
چرا برای توسعهدهندگان مهم است#
دو پیامد این طراحی شیوهی کار امروز ما با مدلهای زبانی را شکل میدهد. چون هر موقعیت به همهی موقعیتهای دیگر توجه میکند، هزینهی توجه با مجذور طول دنباله رشد میکند و به همین دلیل پنجرههای زمینه (context window) محدودیتی واقعیاند. و چون توجه همهی موقعیتها را همزمان وزن میدهد، اینکه چه چیزی را و در کجای زمینه میگذارید بر خروجی اثر دارد. دربارهی جنبهی عملی این موضوع در تولید تقویتشده با بازیابی نوشتهام.
جمعبندی#
- ترنسفورمر بازگشت و کانولوشن را با توجه جایگزین میکند [1].
- توجه برابر است با
softmax(Q·Kᵀ / √d_k) · V؛ عامل√d_kجلوی افتادن softmax به نواحی کمگرادیان را میگیرد [2]. - مدل پایه از ۸ سر با بُعد ۶۴،
d_model = 512، و ۶ لایه در هر یک از رمزگذار و رمزگشا استفاده میکند [2]. - کدگذاریهای موقعیتی سینوسی به مدل درکی از ترتیب میدهند [2].
منابع#
- Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., Polosukhin, I. “Attention Is All You Need.” 2017. Abstract: https://arxiv.org/abs/1706.03762
- The same paper, full text (sections 3.2 and 3.5): https://arxiv.org/html/1706.03762v7
- #ai
- #transformer
- #attention
- #deep-learning
- #research
نوشتهی پارسا علیزاده
محصولات وب و موبایل را از صفر تا انتشار میسازم، همراه با ابزارهای هوش مصنوعی که آنها را هوشمندتر میکنند. رابطهای سریع، سیستمهای تمیز و تحویل بهموقع برایم مهم است.