کوانتیزهسازی مدلهای زبانی بزرگ: وزنهای ۸ بیتی و ۴ بیتی چگونه کار میکنند
چرا یک مدل ۷ میلیارد پارامتری در حالت ۱۶ بیتی به ۱۴ گیگابایت حافظه نیاز دارد، کوانتیزهسازی چطور آن را کوچک میکند، چرا دادههای پرت کار را دشوار میکنند و هر یک از روشهای LLM.int8()، GPTQ، AWQ و QLoRA چه چیزی را تغییر دادند.
 پارسا علیزاده
۶ دقیقه مطالعه
در این صفحه
یک مدل زبانی در اصل فهرستی بسیار بزرگ از اعداد است. اگر هر عدد را در ۱۶ بیت ذخیره کنید، یک مدل ۷ میلیارد پارامتری فقط برای وزنهایش به حدود ۱۴ گیگابایت حافظه نیاز دارد؛ بیشتر از آنچه اغلب لپتاپها و بسیاری از GPUها دارند. کوانتیزهسازی (quantization) این اعداد را با بیتهای کمتری ذخیره میکند تا همان مدل در نصف یا یکچهارم حافظه جا شود. در این نوشته توضیح میدهم این کار چگونه انجام میشود، چرا برای مدلهای زبانی بزرگ دشوارتر از آن است که به نظر میرسد، و روشهای اصلی پژوهشی چه چیزی را تغییر دادند.
حسابوکتاب حافظه#
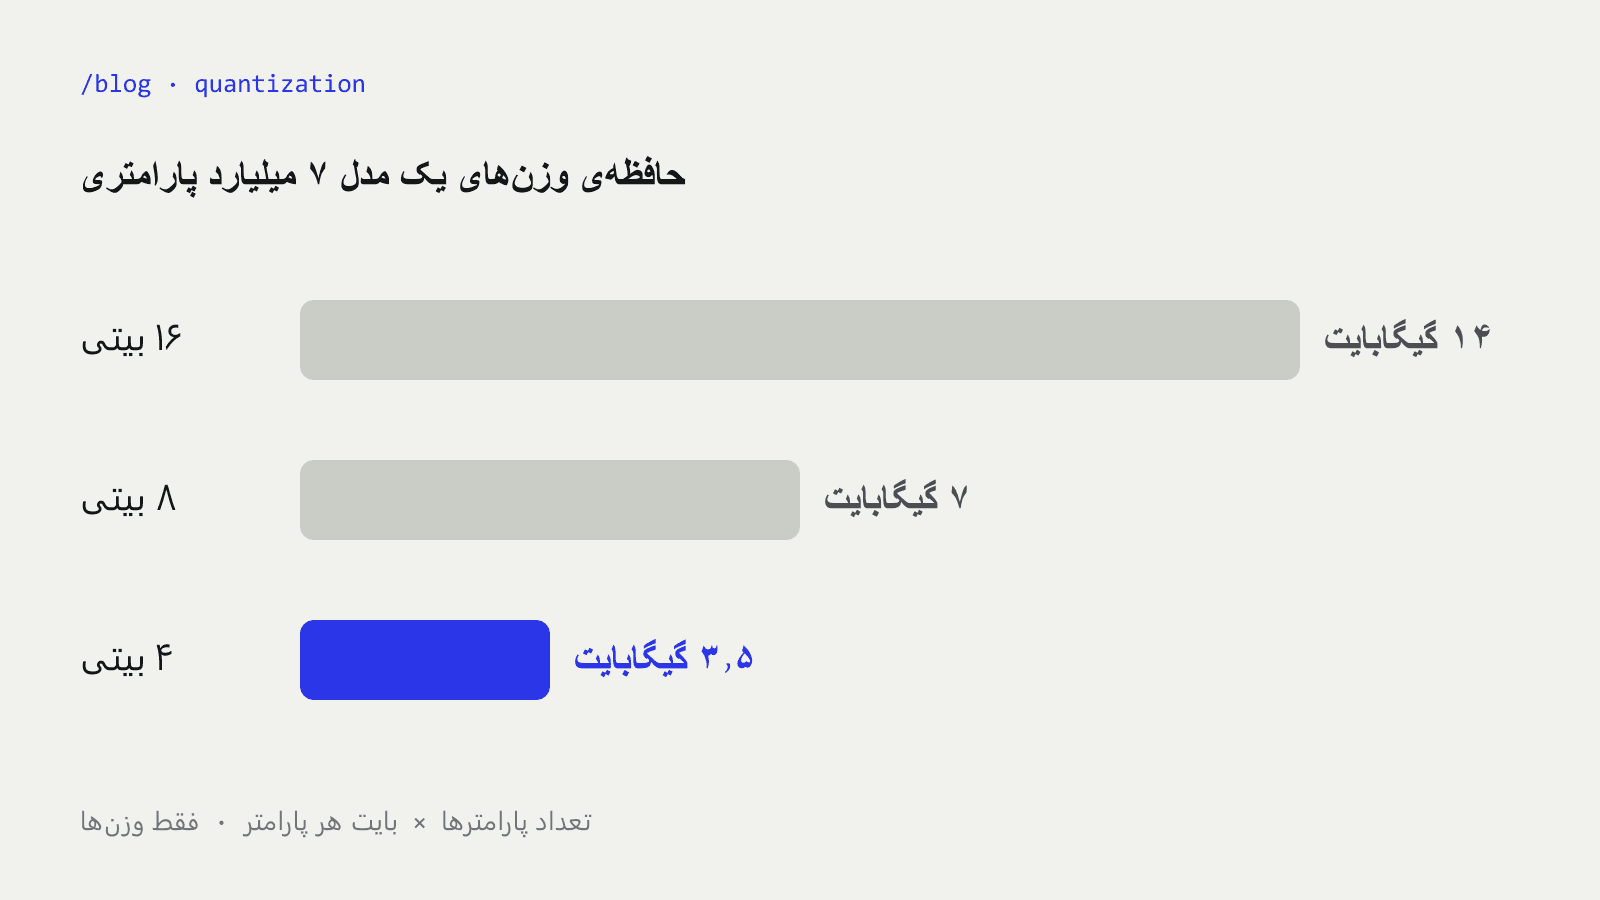
حافظهی وزنها برابر است با تعداد پارامترها ضرب در تعداد بایتهای هر پارامتر:
7,000,000,000 × 2 bytes   (16-bit)  ≈ 14 GB
7,000,000,000 × 1 byte    (8-bit)   ≈  7 GB
7,000,000,000 × 0.5 bytes (4-bit)   ≈  3.5 GB
این فقط وزنهاست. اجرای مدل به حافظه برای فعالسازیها (activations) و همچنین حافظهی نهان کلید-مقدار (key-value cache) هم نیاز دارد که با طولانیتر شدن گفتوگو بزرگتر میشود. با این حال، وزنها معمولاً بزرگترین بخشاند و همان چیزی هستند که کوانتیزهسازی کوچکشان میکند.
حافظه تنها سود این کار نیست. تولید متن بهصورت توکنبهتوکن اغلب به سرعت خواندن وزنها از حافظه محدود است، نه به محاسبات. وزنهای کوچکتر یعنی دادهی کمتری باید جابهجا شود و این میتواند تولید متن را هم سریعتر کند [3].
کوانتیزهسازی چگونه کار میکند#
سادهترین روش، کوانتیزهسازی absmax است. بزرگترین مقدار مطلق را در یک تانسور (tensor) پیدا کنید، آن را به بزرگترین عدد صحیح موجود نگاشت کنید و بقیهی مقادیر را با همان نسبت مقیاسدهی کنید. برای ۸ بیت، اعداد صحیح از ۱۲۷− تا ۱۲۷ هستند.
import numpy as np

def quantize(x, bits=8):
    qmax = 2 ** (bits - 1) - 1          # 127 for 8 bits, 7 for 4 bits
    scale = np.abs(x).max() / qmax      # one scale for the whole tensor
    q = np.clip(np.round(x / scale), -qmax, qmax).astype(np.int8)
    return q, scale

def dequantize(q, scale):
    return q.astype(np.float32) * scale

rng = np.random.default_rng(0)
w = rng.normal(0, 0.02, size=4096).astype(np.float32)

q, s = quantize(w)
print("error without outlier:", np.abs(w - dequantize(q, s)).mean())

w[0] = 1.0                              # a single large value
q, s = quantize(w)
print("error with outlier:   ", np.abs(w - dequantize(q, s)).mean())
اگر آن را اجرا کنید، خطای دوم بسیار بزرگتر است. همان یک مقدار بزرگ مقیاس را تعیین میکند، پس فاصلهی میان اعداد صحیح مجاور زیاد میشود و هزاران وزن کوچک و معمولی بهشکلی زمخت گرد میشوند. بیشترشان فقط روی چند مقدار صحیح انگشتشمار جمع میشوند.
این همان دشواری اصلی کوانتیزهسازی است: دادههای پرت (outliers). دو راهکار استاندارد برای مقابله با آن وجود دارد:
- گروههای کوچکتر. به هر بلوک، مثلاً ۶۴ یا ۱۲۸ وزن، مقیاس جداگانهای بدهید تا یک دادهی پرت فقط به بلوک خودش آسیب بزند. بیشتر قالبهای ۴ بیتی همین کار را میکنند.
- نقطههای صفر (zero points). بازه را جابهجا کنید تا لازم نباشد حول صفر متمرکز باشد؛ این کار وقتی مقادیر بیشتر مثبت یا بیشتر منفیاند کمک میکند.
دادههای پرت در مدلهای بزرگ: LLM.int8()#
Tim Dettmers و همکارانش دریافتند که دادههای پرت در مدلهای زبانی بزرگ تصادفی نیستند [1]. این دادهها در فعالسازیها ظاهر میشوند، در تعداد کمی از ابعاد ویژگی (feature dimensions) متمرکزند و با بزرگتر شدن مدلها حالتی نظاممند پیدا میکنند؛ با تغییری ناگهانی در حدود ۶٫۷ میلیارد پارامتر [1]. کوانتیزهسازی سادهی ۸ بیتی در همین نقطه از کار میافتد.
روش آنها، LLM.int8()، این مشکل را با تجزیهی دقت ترکیبی (mixed-precision decomposition) حل میکند [1]. ابعاد معدودِ دارای دادهی پرت در ۱۶ بیت ضرب میشوند و بقیه، یعنی حدود ۹۹٫۹٪ مقادیر، در ۸ بیت. با این روش، آنها مدلهایی تا ۱۷۵ میلیارد پارامتر را بدون افت عملکرد در ۸ بیت اجرا کردند [1].
وزنهای ۴ بیتی: GPTQ و AWQ#
پایین آمدن تا ۴ بیت به چیزی بیش از گرد کردن نیاز دارد. دو روش بهطور گسترده استفاده میشوند.
GPTQ، اثر Elias Frantar و همکارانش، وزنها را ستونبهستون کوانتیزه میکند و با استفاده از اطلاعات تقریبی مرتبهی دوم دربارهی لایه، وزنهای باقیمانده را برای جبران خطای گرد کردن تنظیم میکند [2]. این روش مدلهای ۱۷۵ میلیارد پارامتری را در حدود چهار ساعت GPU به ۳ یا ۴ بیت کوانتیزه کرد، با افت دقتی ناچیز در مقایسه با مدل ۱۶ بیتی [2].
AWQ، اثر Ji Lin و همکارانش، از این مشاهده آغاز میکند که همهی وزنها به یک اندازه اهمیت ندارند [3]. محافظت از تنها حدود ۱٪ از وزنهای برجسته (salient) خطا را بهشدت کاهش میدهد، و بهترین راه یافتن این وزنها نگاه کردن به اندازهی فعالسازیهاست، نه اندازهی وزنها [3]. AWQ بهجای نگه داشتن این وزنها با دقت بالاتر، کانالهای مهم را پیش از کوانتیزهسازی بزرگمقیاس میکند؛ به این ترتیب کل تانسور در یک قالب باقی میماند و به آموزش مجدد نیازی نیست [3].
هر دو روش فقط-وزن (weight-only) هستند: وزنها در ۴ بیت ذخیره میشوند و برای عمل ضرب به ۱۶ بیت بازگردانده میشوند. کوانتیزه کردن فعالسازیها هم دشوارتر است، چون دادههای پرت فعالسازی با هر ورودی تغییر میکنند. SmoothQuant، اثر Guangxuan Xiao و همکارانش، با انتقال ریاضیِ بخشی از این دشواری از فعالسازیها به وزنها به این مسئله میپردازد و امکان استفادهی همزمان از وزنهای ۸ بیتی و فعالسازیهای ۸ بیتی را فراهم میکند [4].
تنظیم دقیق یک مدل کوانتیزهشده: QLoRA#
کوانتیزهسازی در ابتدا فقط برای استنتاج (inference) به کار میرفت. QLoRA، اثر Tim Dettmers و همکارانش، تنظیم دقیق (fine-tuning) روی یک مدل ۴ بیتی را ممکن کرد [5]. مدل پایه در ۴ بیت منجمد باقی میماند و آداپتورهای کوچک و قابلآموزشِ کمرتبه (LoRA) به آن اضافه و در ۱۶ بیت آموزش داده میشوند [5].
این مقاله سه جزء را معرفی کرد [5]:
- NF4 (4-bit NormalFloat): یک نوع دادهی ۴ بیتی که سطوح آن برای وزنهایی با توزیع نرمال فاصلهگذاری شدهاند؛ وزنهای آموزشدیده معمولاً همینگونه توزیع شدهاند.
- کوانتیزهسازی دوگانه (double quantization): خودِ مقیاسها هم کوانتیزه میشوند و حافظهی بیشتری صرفهجویی میشود.
- بهینهسازهای صفحهبندیشده (paged optimizers): وضعیت بهینهساز میتواند میان حافظهی GPU و CPU جابهجا شود تا از جهشهای ناگهانی مصرف حافظه جان سالم به در ببرد.
با این اجزا، میشد یک مدل ۶۵ میلیارد پارامتری را روی یک GPU ۴۸ گیگابایتی تنظیم دقیق کرد و در وظایف آزمودهشده به نتایجی همتراز با تنظیم دقیق کامل ۱۶ بیتی رسید [5].
انتخاب در عمل#
- ۸ بیتی برای بیشتر مدلها تقریباً بدون اتلاف است و حافظه را نصف میکند [1].
- ۴ بیتیِ فقط-وزن (GPTQ، AWQ یا قالب گروهی مشابه) انتخاب رایج برای اجرای محلی مدلهاست و یکچهارم حافظهی ۱۶ بیتی را مصرف میکند [2] [3].
- کمتر از ۴ بیت کیفیت معمولاً بهطور محسوسی افت میکند؛ با دقت آزمایش کنید.
- برای تنظیم دقیق روی سختافزار محدود، QLoRA نقطهی شروع استاندارد است [5].
جمعبندی#
- حافظهی وزنها برابر است با تعداد پارامترها ضرب در بایتهای هر پارامتر: برای یک مدل 7B در ۱۶، ۸ و ۴ بیت بهترتیب حدود ۱۴، ۷ و ۳٫۵ گیگابایت.
- کوانتیزهسازی مقادیر را با یک مقیاس به مجموعهی کوچکی از اعداد صحیح نگاشت میکند؛ دادههای پرت مقیاس را زمخت میکنند.
- LLM.int8() ابعاد نادرِ دارای دادهی پرت را در ۱۶ بیت نگه میدارد [1]؛ GPTQ خطای گرد کردن را جبران میکند [2]؛ AWQ با مقیاسدهی از کانالهای برجسته محافظت میکند [3].
- QLoRA آداپتورهای کوچکی را روی یک مدل ۴ بیتیِ منجمد آموزش میدهد [5].
برای اینکه ببینید این مدلها اصلاً چگونه محاسبه میکنند، نوشتهی سازوکار توجه در ترنسفورمرها را بخوانید.
منابع#
- Dettmers, T., Lewis, M., Belkada, Y., Zettlemoyer, L. “LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale.” NeurIPS 2022. https://arxiv.org/abs/2208.07339
- Frantar, E., Ashkboos, S., Hoefler, T., Alistarh, D. “GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers.” ICLR 2023. https://arxiv.org/abs/2210.17323
- Lin, J., Tang, J., Tang, H., Yang, S., Chen, W.-M., Wang, W.-C., Xiao, G., Dang, X., Gan, C., Han, S. “AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration.” MLSys 2024. https://arxiv.org/abs/2306.00978
- Xiao, G., Lin, J., Seznec, M., Wu, H., Demouth, J., Han, S. “SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models.” ICML 2023. https://arxiv.org/abs/2211.10438
- Dettmers, T., Pagnoni, A., Holtzman, A., Zettlemoyer, L. “QLoRA: Efficient Finetuning of Quantized LLMs.” NeurIPS 2023. https://arxiv.org/abs/2305.14314
- #ai
- #llm
- #quantization
- #inference
- #research
نوشتهی پارسا علیزاده
محصولات وب و موبایل را از صفر تا انتشار میسازم، همراه با ابزارهای هوش مصنوعی که آنها را هوشمندتر میکنند. رابطهای سریع، سیستمهای تمیز و تحویل بهموقع برایم مهم است.