تولید تقویتشده با بازیابی: از مقالهی اصلی تا یک پایپلاین کارآمد
RAG بر اساس مقالهی ۲۰۲۰ که این نام را بر آن گذاشت چیست، یک پایپلاین کاربردی از چه بخشهایی تشکیل میشود، و پژوهشها دربارهی جای قرار دادن متن بازیابیشده در پرامپت چه میگویند.
 پارسا علیزاده
۳ دقیقه مطالعه
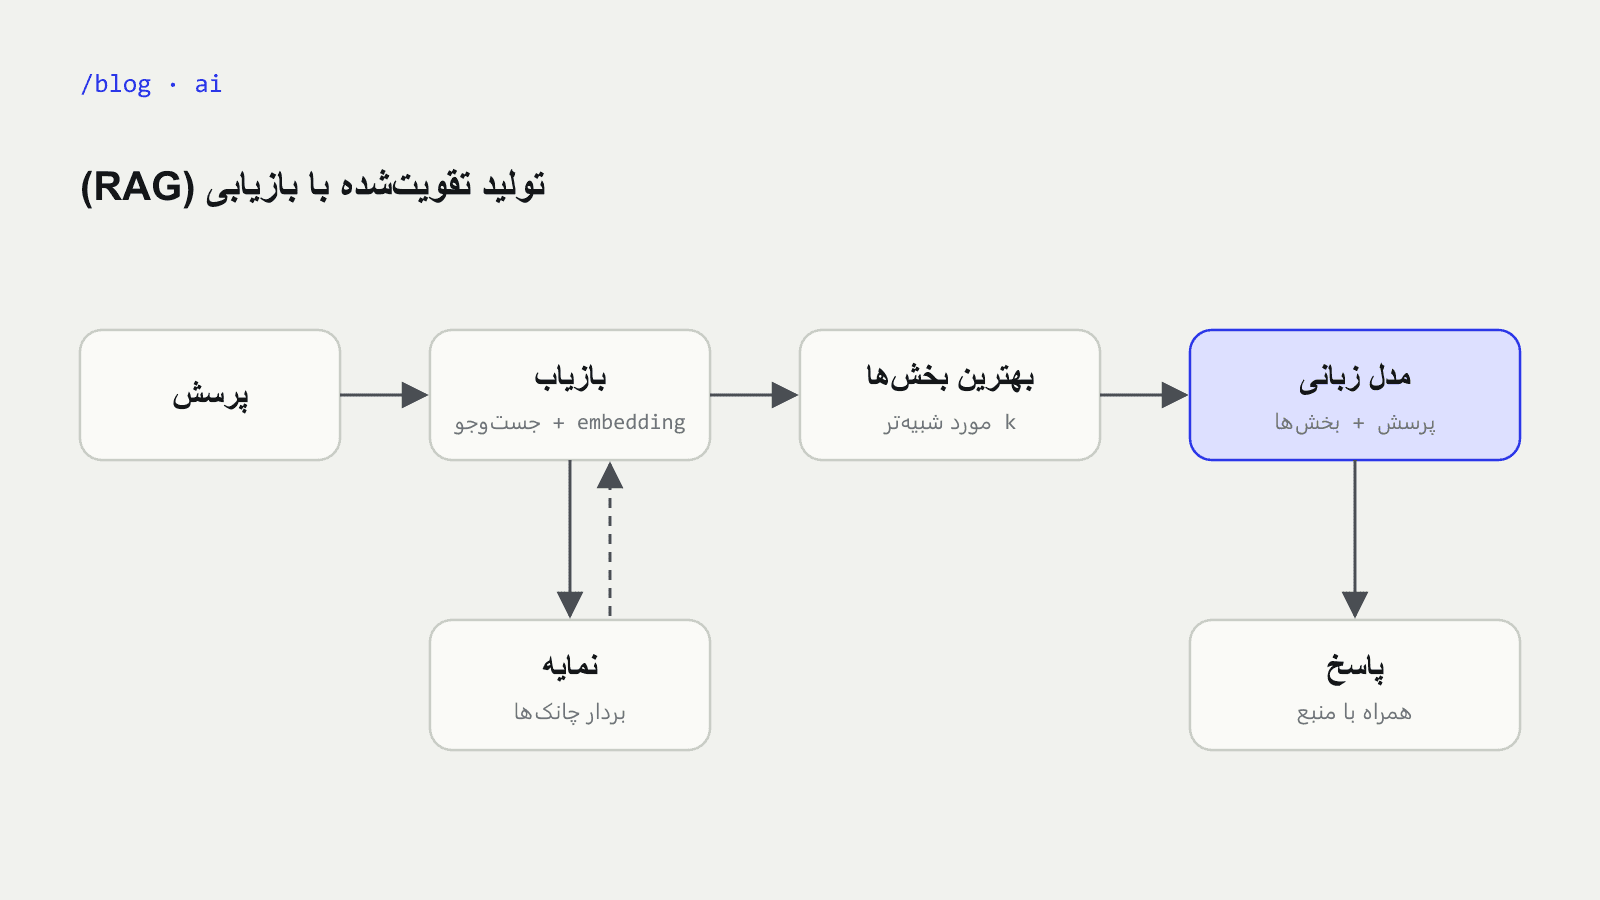
مدلهای زبانی بزرگ بر اساس آنچه در طول آموزش جذب کردهاند پاسخ میدهند. این دانش ممکن است کهنه یا ناقص باشد، یا نتوان آن را به منبعی ردیابی کرد. تولید تقویتشده با بازیابی (Retrieval-Augmented Generation)، که معمولاً به اختصار RAG نامیده میشود، رایجترین راه برای رساندن اطلاعات درست به مدل در همان لحظهای است که پاسخ میدهد. این نوشته با مقالهای شروع میشود که این اصطلاح را معرفی کرد و سپس پایپلاین (pipeline) را آنطور که معمولاً ساخته میشود شرح میدهد.
این نام از کجا آمده است#
این اصطلاح از مقالهی «Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks» نوشتهی Patrick Lewis و همکارانش میآید که در NeurIPS 2020 منتشر شد [1].
این مقاله دو نوع حافظه را توصیف میکند [1]:
- حافظهی پارامتری (parametric memory): دانشی که در وزنهای یک مدل از پیش آموزشدیدهی دنبالهبهدنباله (sequence-to-sequence) ذخیره شده است.
- حافظهی ناپارامتری (non-parametric memory): یک نمایهی برداری چگال (dense vector index) از ویکیپدیا که با یک بازیاب عصبی از پیش آموزشدیده به آن دسترسی پیدا میشود.
RAG این دو را با هم ترکیب میکند. بازیاب (retriever) بخشهای مرتبط را پیدا میکند و مولد (generator) خروجی خود را بر پایهی آنها مینویسد.
مقاله دو صورتبندی را با هم مقایسه میکند [1]. در یکی، کل دنبالهی تولیدشده بر پایهی همان بخشهای بازیابیشده ساخته میشود (RAG-Sequence). در دیگری، برای هر توکن میتوان از بخشهای متفاوتی استفاده کرد (RAG-Token).
نویسندگان گزارش میدهند که مدلهای RAG در مقایسه با یک خط پایهی صرفاً پارامتری، زبانی مشخصتر، متنوعتر و مبتنیتر بر واقعیت تولید کردند و در چند وظیفهی پرسشوپاسخ دامنهباز (open-domain question answering) به بهترین نتیجهی روز رسیدند [1].
پایپلاین، گام به گام#
بیشتر سامانههای RAG که امروز ساخته میشوند همان شکل مقاله را دنبال میکنند، با این تفاوت که بهجای ویکیپدیا یک نمایهی خارجی دارند:
- تقسیم: اسناد منبع به بخشهایی تقسیم میشوند که اغلب به آنها چانک (chunk) گفته میشود.
- تعبیه: هر چانک با یک مدل تعبیه (embedding model) به بردار تبدیل میشود.
- نمایهسازی: بردارها نمایهسازی (indexing) میشوند تا بتوان بردارهای مشابه را سریع پیدا کرد.
- بازیابی: چانکهایی که بردارشان به بردار پرسش نزدیکتر است بازیابی (retrieval) میشوند.
- تولید: پاسخ با یک مدل زبانی تولید میشود؛ پرسش همراه با چانکهای بازیابیشده به مدل داده میشود.
از آنجا که پاسخ از بخشهای مشخصی ساخته میشود، سامانه میتواند نشان دهد از کدام بخشها استفاده کرده است. اغلب، دلیل اصلی ساختن RAG همین است: پاسخهایی که میشود درستیشان را بررسی کرد.
جای متن بازیابیشده اهمیت دارد#
دادن زمینهی (context) بیشتر به مدل خودبهخود بهتر نیست. Nelson F. Liu و همکارانش در مقالهی «Lost in the Middle» دریافتند که عملکرد مدل اغلب زمانی بیشترین است که اطلاعات مرتبط در ابتدا یا انتهای ورودی باشد، و وقتی این اطلاعات در میانهی یک زمینهی طولانی قرار میگیرد، عملکرد بهطور چشمگیری افت میکند [2]. آنها این پدیده را حتی در مدلهایی دیدند که برای زمینههای طولانی طراحی شده بودند [2].
دو پیامد عملی از این یافته به دست میآید:
- بهجای بازیابی هر تعداد بخشی که پنجرهی زمینه (context window) جا دارد، بخشهای کمتر اما بهتری بازیابی کنید.
- مرتبطترین بخشها را جایی بگذارید که احتمال استفادهی مدل از آنها بیشتر است، یعنی در ابتدا یا انتهای زمینه.
جمعبندی#
- RAG یک بازیاب روی نمایهای خارجی را با مولدی جفت میکند که از روی آنچه بازیابی شده مینویسد [1].
- پایپلاین عملی شامل تقسیم، تعبیه، نمایهسازی، بازیابی و تولید است.
- جایگاه اهمیت دارد: مدل از متن مرتبطی که در ابتدا یا انتهای زمینه باشد با اطمینان بیشتری استفاده میکند تا از متنی که در میانه است [2].
- مزیت اصلی، پاسخهایی است که بر منابعی قابل نمایش تکیه دارند.
در موضوعی دیگر: اگر نوشتههای فنیای از این دست را با نام خودتان منتشر میکنید، بهتر است خودتان را با دادههای ساختاریافته به موتورهای جستوجو معرفی کنید.
منابع#
- Lewis, P., Perez, E., Piktus, A., Petroni, F., Karpukhin, V., Goyal, N., Küttler, H., Lewis, M., Yih, W., Rocktäschel, T., Riedel, S., Kiela, D. “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks.” NeurIPS 2020. https://arxiv.org/abs/2005.11401
- Liu, N. F., Lin, K., Hewitt, J., Paranjape, A., Bevilacqua, M., Petroni, F., Liang, P. “Lost in the Middle: How Language Models Use Long Contexts.” 2023. https://arxiv.org/abs/2307.03172
- #ai
- #llm
- #rag
- #retrieval
نوشتهی پارسا علیزاده
محصولات وب و موبایل را از صفر تا انتشار میسازم، همراه با ابزارهای هوش مصنوعی که آنها را هوشمندتر میکنند. رابطهای سریع، سیستمهای تمیز و تحویل بهموقع برایم مهم است.