Büyük dil modellerini nicelemek: 8 bit ve 4 bit ağırlıklar nasıl çalışır
7 milyar parametreli bir modelin 16 bitte neden 14 GB’a ihtiyaç duyduğu, nicelemenin bunu nasıl küçülttüğü, aykırı değerlerin işi neden zorlaştırdığı ve LLM.int8(), GPTQ, AWQ ile QLoRA’nın her birinin neyi değiştirdiği.
 Parsa Alizadeh
5 dk okuma
Bu sayfada
Bir dil modeli, büyük ölçüde çok uzun bir sayı listesidir. Bu sayıların her birini 16 bitte saklarsanız, 7 milyar parametreli bir model yalnızca ağırlıkları için yaklaşık 14 GB’a ihtiyaç duyar; bu, çoğu dizüstü bilgisayarın ve pek çok GPU’nun sahip olduğundan fazladır. Niceleme (quantization), bu sayıları daha az bitle saklar; böylece aynı model belleğin yarısına ya da dörtte birine sığar. Bu yazıda nicelemenin nasıl çalıştığını, büyük dil modellerinde göründüğünden neden daha zor olduğunu ve başlıca araştırma yöntemlerinin neleri değiştirdiğini anlatıyorum.
Bellek hesabı#
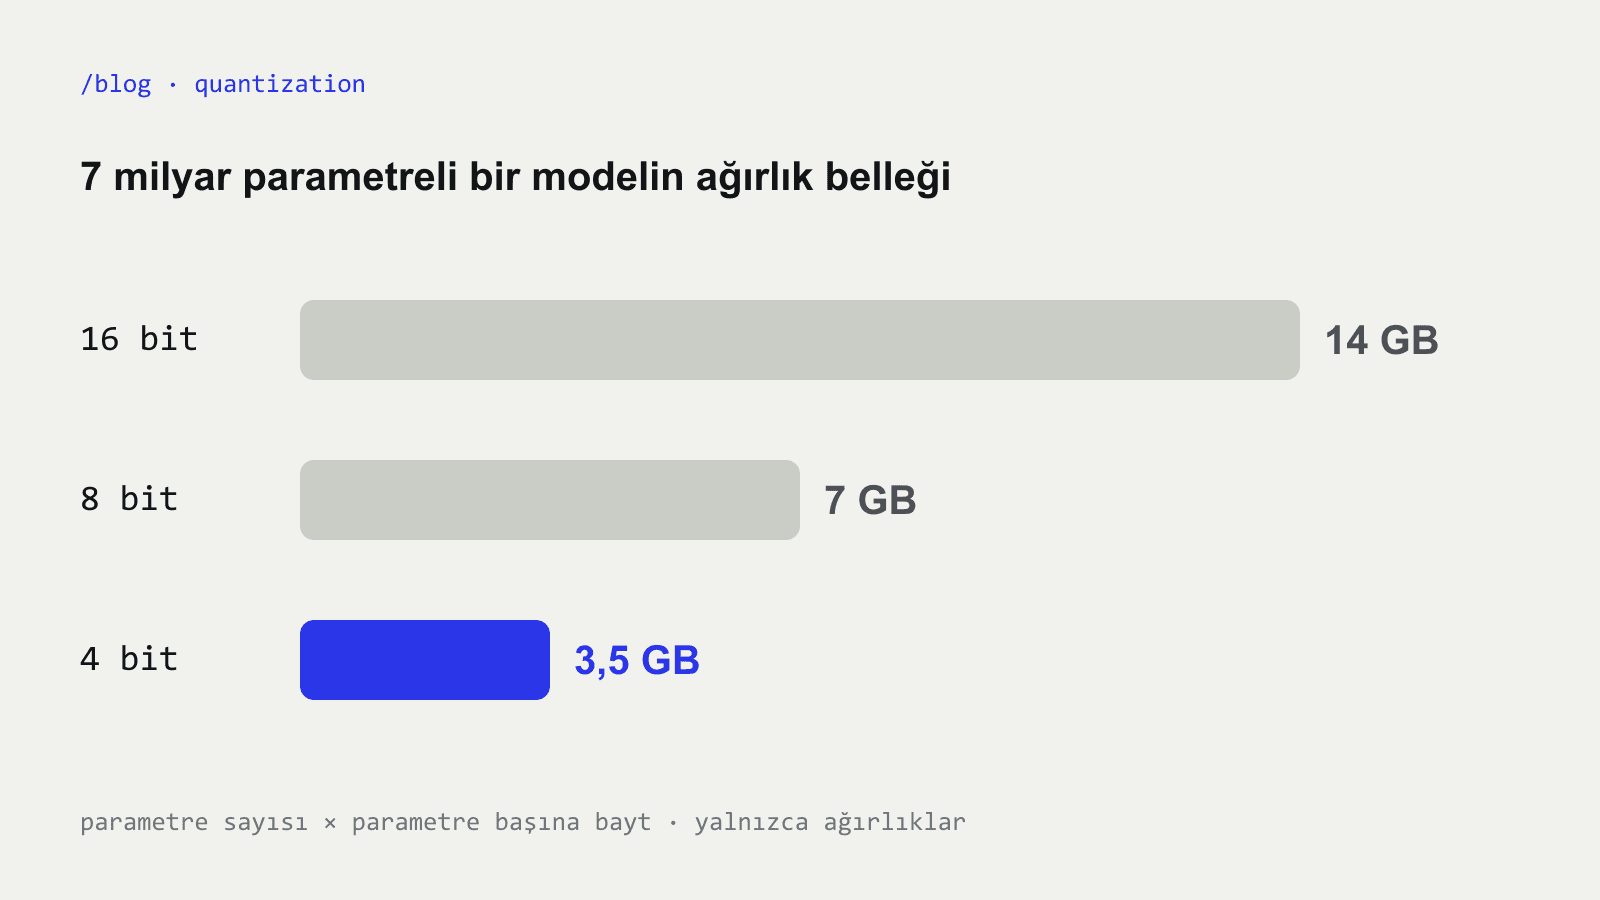
Ağırlık belleği, parametre sayısı ile parametre başına bayt sayısının çarpımıdır:
7,000,000,000 × 2 bytes   (16-bit)  ≈ 14 GB
7,000,000,000 × 1 byte    (8-bit)   ≈  7 GB
7,000,000,000 × 0.5 bytes (4-bit)   ≈  3.5 GB
Bu yalnızca ağırlıklar içindir. Modeli çalıştırmak ayrıca aktivasyonlar ve konuşmanın uzunluğuyla birlikte büyüyen anahtar-değer önbelleği (key-value cache) için de bellek gerektirir. Yine de ağırlıklar genellikle en büyük paydır ve nicelemenin küçülttüğü de onlardır.
Kazanç yalnızca bellekle sınırlı değildir. Metni her seferinde bir token üreterek oluşturmak, çoğu zaman aritmetikle değil, ağırlıkların bellekten ne kadar hızlı okunabildiğiyle sınırlıdır. Daha küçük ağırlıklar, taşınacak verinin azalması demektir; bu da üretimi hızlandırabilir [3].
Niceleme nasıl çalışır#
En basit yöntem absmax nicelemedir. Bir tensördeki en büyük mutlak değeri bulur, onu kullanılabilir en büyük tam sayıya eşler ve geri kalan her şeyi buna göre ölçeklersiniz. 8 bit için tam sayılar −127 ile 127 arasındadır.
import numpy as np

def quantize(x, bits=8):
    qmax = 2 ** (bits - 1) - 1          # 127 for 8 bits, 7 for 4 bits
    scale = np.abs(x).max() / qmax      # one scale for the whole tensor
    q = np.clip(np.round(x / scale), -qmax, qmax).astype(np.int8)
    return q, scale

def dequantize(q, scale):
    return q.astype(np.float32) * scale

rng = np.random.default_rng(0)
w = rng.normal(0, 0.02, size=4096).astype(np.float32)

q, s = quantize(w)
print("error without outlier:", np.abs(w - dequantize(q, s)).mean())

w[0] = 1.0                              # a single large value
q, s = quantize(w)
print("error with outlier:   ", np.abs(w - dequantize(q, s)).mean())
Kodu çalıştırdığınızda ikinci hatanın çok daha büyük olduğunu görürsünüz. Tek bir büyük değer ölçeği belirler; bu yüzden komşu tam sayılar arasındaki adım genişler ve binlerce küçük, sıradan ağırlık kaba biçimde yuvarlanır. Bunların çoğu yalnızca birkaç tam sayı değerine yığılır.
Nicelemenin temel zorluğu budur: aykırı değerler (outliers). İki standart savunma yöntemi vardır:
- Daha küçük gruplar. Örneğin her 64 ya da 128 ağırlıklık bloğa kendi ölçeğini verin; böylece bir aykırı değer yalnızca kendi bloğuna zarar verir. 4 bitlik formatların çoğu bunu yapar.
- Sıfır noktaları. Aralığı, sıfır etrafında ortalanmak zorunda kalmayacak şekilde kaydırın; bu, değerler çoğunlukla pozitif ya da çoğunlukla negatif olduğunda işe yarar.
Büyük modellerde aykırı değerler: LLM.int8()#
Tim Dettmers ve meslektaşları, büyük dil modellerindeki aykırı değerlerin rastgele olmadığını buldu [1]. Bu değerler aktivasyonlarda, az sayıda öznitelik boyutunda yoğunlaşmış olarak ortaya çıkıyor ve modeller büyüdükçe sistematik hâle geliyor; yaklaşık 6,7 milyar parametrede keskin bir değişim yaşanıyor [1]. Basit 8 bitlik niceleme bu noktada çöküyor.
Onların yöntemi olan LLM.int8(), bu sorunu karma hassasiyetli ayrıştırma (mixed-precision decomposition) ile çözüyor [1]. Az sayıdaki aykırı boyut 16 bitte, geri kalan her şey, yani değerlerin yaklaşık %99,9’u ise 8 bitte çarpılıyor. Bu sayede 175 milyar parametreye kadar olan modelleri performans kaybı olmadan 8 bitte çalıştırdılar [1].
4 bitlik ağırlıklar: GPTQ ve AWQ#
4 bite inmek, yuvarlamadan fazlasını gerektirir. Yaygın olarak kullanılan iki yöntem vardır.
Elias Frantar ve meslektaşlarının geliştirdiği GPTQ, ağırlıkları her seferinde bir sütun olmak üzere nicelendirir ve katman hakkındaki yaklaşık ikinci dereceden bilgiyi kullanarak, yuvarlama hatasını telafi etmek için kalan ağırlıkları ayarlar [2]. 175 milyar parametreli modelleri yaklaşık dört GPU saatinde 3 ya da 4 bite nicelendirdi ve 16 bitlik modele kıyasla ihmal edilebilir bir doğruluk kaybı yaşandı [2].
Ji Lin ve meslektaşlarının geliştirdiği AWQ, tüm ağırlıkların eşit derecede önemli olmadığı gözleminden yola çıkar [3]. Önemli (salient) ağırlıkların yalnızca yaklaşık %1’ini korumak hatayı büyük ölçüde azaltır ve bu önemli ağırlıklar en iyi, ağırlık büyüklüklerine değil aktivasyon büyüklüklerine bakılarak bulunur [3]. AWQ, bu ağırlıkları daha yüksek hassasiyette tutmak yerine önemli kanalları niceleme öncesinde büyütecek şekilde ölçekler; bu, tüm tensörü tek bir formatta tutar ve yeniden eğitim gerektirmez [3].
Her ikisi de yalnızca ağırlık (weight-only) yöntemleridir: Ağırlıklar 4 bitte saklanır ve çarpma işlemi için tekrar 16 bite dönüştürülür. Aktivasyonları da nicelemek daha zordur, çünkü aktivasyon aykırı değerleri her girdiyle birlikte değişir. Guangxuan Xiao ve meslektaşlarının geliştirdiği SmoothQuant, zorluğun bir kısmını matematiksel olarak aktivasyonlardan ağırlıklara taşıyarak bu soruna çözüm getirir; bu da 8 bitlik ağırlıkları ve 8 bitlik aktivasyonları birlikte kullanmayı mümkün kılar [4].
Nicelenmiş bir modelde ince ayar: QLoRA#
Niceleme ilk başta yalnızca çıkarım (inference) için kullanılıyordu. Tim Dettmers ve meslektaşlarının geliştirdiği QLoRA, 4 bitlik bir modelin üzerinde ince ayar (fine-tuning) yapmayı mümkün kıldı [5]. Temel model 4 bitte dondurulmuş olarak kalır; küçük, eğitilebilir düşük ranklı adaptörler (LoRA) eklenir ve 16 bitte eğitilir [5].
Makale üç bileşen tanıttı [5]:
- NF4 (4-bit NormalFloat): Seviyeleri normal dağılımlı ağırlıklara göre aralıklandırılmış 4 bitlik bir veri türü; eğitilmiş ağırlıklar da genellikle bu şekilde dağılır.
- Çift niceleme (double quantization): Ölçeklerin kendileri de nicelenir ve böylece daha fazla bellek tasarrufu sağlanır.
- Sayfalı optimize ediciler (paged optimizers): Optimize edici durumu, bellek ani yükselmelerini atlatmak için GPU ve CPU belleği arasında taşınabilir.
Bunlar sayesinde 65 milyar parametreli bir model, tek bir 48 GB GPU üzerinde ince ayardan geçirilebildi ve test edilen görevlerde tam 16 bitlik ince ayarın sonuçlarına ulaştı [5].
Pratikte seçim yapmak#
- 8 bit, çoğu model için neredeyse kayıpsızdır ve belleği yarıya indirir [1].
- Yalnızca ağırlık 4 bit (GPTQ, AWQ ya da benzer bir grup bazlı format), modelleri yerelde çalıştırmak için olağan tercihtir ve 16 bitlik belleğin dörtte birini kullanır [2] [3].
- 4 bitin altında kalite genellikle belirgin biçimde düşer; dikkatle test edin.
- Sınırlı donanımda ince ayar için standart başlangıç noktası QLoRA’dır [5].
Özet#
- Ağırlık belleği, parametre sayısı çarpı parametre başına bayttır: 7B’lik bir model için 16, 8 ve 4 bitte sırasıyla yaklaşık 14 GB, 7 GB ve 3,5 GB.
- Niceleme, değerleri bir ölçek yardımıyla küçük bir tam sayı kümesine eşler; aykırı değerler ölçeği kabalaştırır.
- LLM.int8(), nadir görülen aykırı boyutları 16 bitte tutar [1]; GPTQ yuvarlama hatasını telafi eder [2]; AWQ önemli kanalları ölçekleme yoluyla korur [3].
- QLoRA, dondurulmuş 4 bitlik bir modelin üzerinde küçük adaptörler eğitir [5].
Bu modellerin en baştan nasıl hesap yaptığını merak ediyorsanız transformer dikkat mekanizmasının nasıl çalıştığı yazısına göz atın.
Kaynaklar#
- Dettmers, T., Lewis, M., Belkada, Y., Zettlemoyer, L. “LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale.” NeurIPS 2022. https://arxiv.org/abs/2208.07339
- Frantar, E., Ashkboos, S., Hoefler, T., Alistarh, D. “GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers.” ICLR 2023. https://arxiv.org/abs/2210.17323
- Lin, J., Tang, J., Tang, H., Yang, S., Chen, W.-M., Wang, W.-C., Xiao, G., Dang, X., Gan, C., Han, S. “AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration.” MLSys 2024. https://arxiv.org/abs/2306.00978
- Xiao, G., Lin, J., Seznec, M., Wu, H., Demouth, J., Han, S. “SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models.” ICML 2023. https://arxiv.org/abs/2211.10438
- Dettmers, T., Pagnoni, A., Holtzman, A., Zettlemoyer, L. “QLoRA: Efficient Finetuning of Quantized LLMs.” NeurIPS 2023. https://arxiv.org/abs/2305.14314
- #ai
- #llm
- #quantization
- #inference
- #research
Yazan: Parsa Alizadeh
Web ve mobil ürünleri baştan sona geliştiriyorum; onları daha akıllı hale getiren yapay zekâ araçlarıyla birlikte. Hızlı arayüzler, temiz sistemler ve işi teslim etmek benim için önemli.