Dil modelleri metni nasıl okur: token’lar, BPE ve Türkçenin neden daha pahalı olduğu
Token nedir, BPE sözlüğü nasıl kurar, Farsça ve Türkçe neden İngilizceden daha fazla token tutar ve tahmin etmek yerine token nasıl sayılır.
 Parsa Alizadeh
4 dk okuma
Bu sayfada
Bir dil modeli hiçbir zaman harf ya da kelime görmez. Token görür: numaralandırılmış metin parçaları; bazen bir kelimenin tamamı, bazen yalnızca bir bölümü. Bir LLM ürünündeki her sınır ve her fiyat token ile sayılır: bağlam penceresi, çıktı sınırı, fatura. Bu yazı token’ın ne olduğunu, en yaygın yöntemin sözlüğünü nasıl kurduğunu ve aynı cümlenin Farsça ya da Türkçede neden İngilizceden pahalıya geldiğini anlatıyor.
Neden kelime ya da karakter değil#
Metni kelimelere bölmek kısa diziler verir, ama sözlük hiç bitmez. İsimler, yazım hataları, kod ve yeni deyimler hep dışarıda kalır; model, sözlükte karşılığı olmayan bir kelimeyi okuyamaz. Karakterlere bölmenin sorunu tam tersidir: hiçbir şey bilinmeyen değildir, ama diziler çok uzar ve model anlamdan önce yazımı öğrenmek zorunda kalır.
Alt kelime (subword) tokenizasyonu ikisinin arasındadır. Sık geçen kelimeler tek token olur, seyrek kelimeler daha küçük parçalardan hecelenir. Sennrich, Haddow ve Birch bunu çeviri modelleri için önerdi: seyrek ve bilinmeyen kelimeler, byte pair encoding sıkıştırma algoritmasına dayanan bir bölütlemeyle, alt kelime birimlerinin dizisi olarak kodlanır [1].
Byte pair encoding sözlüğü nasıl öğrenir#
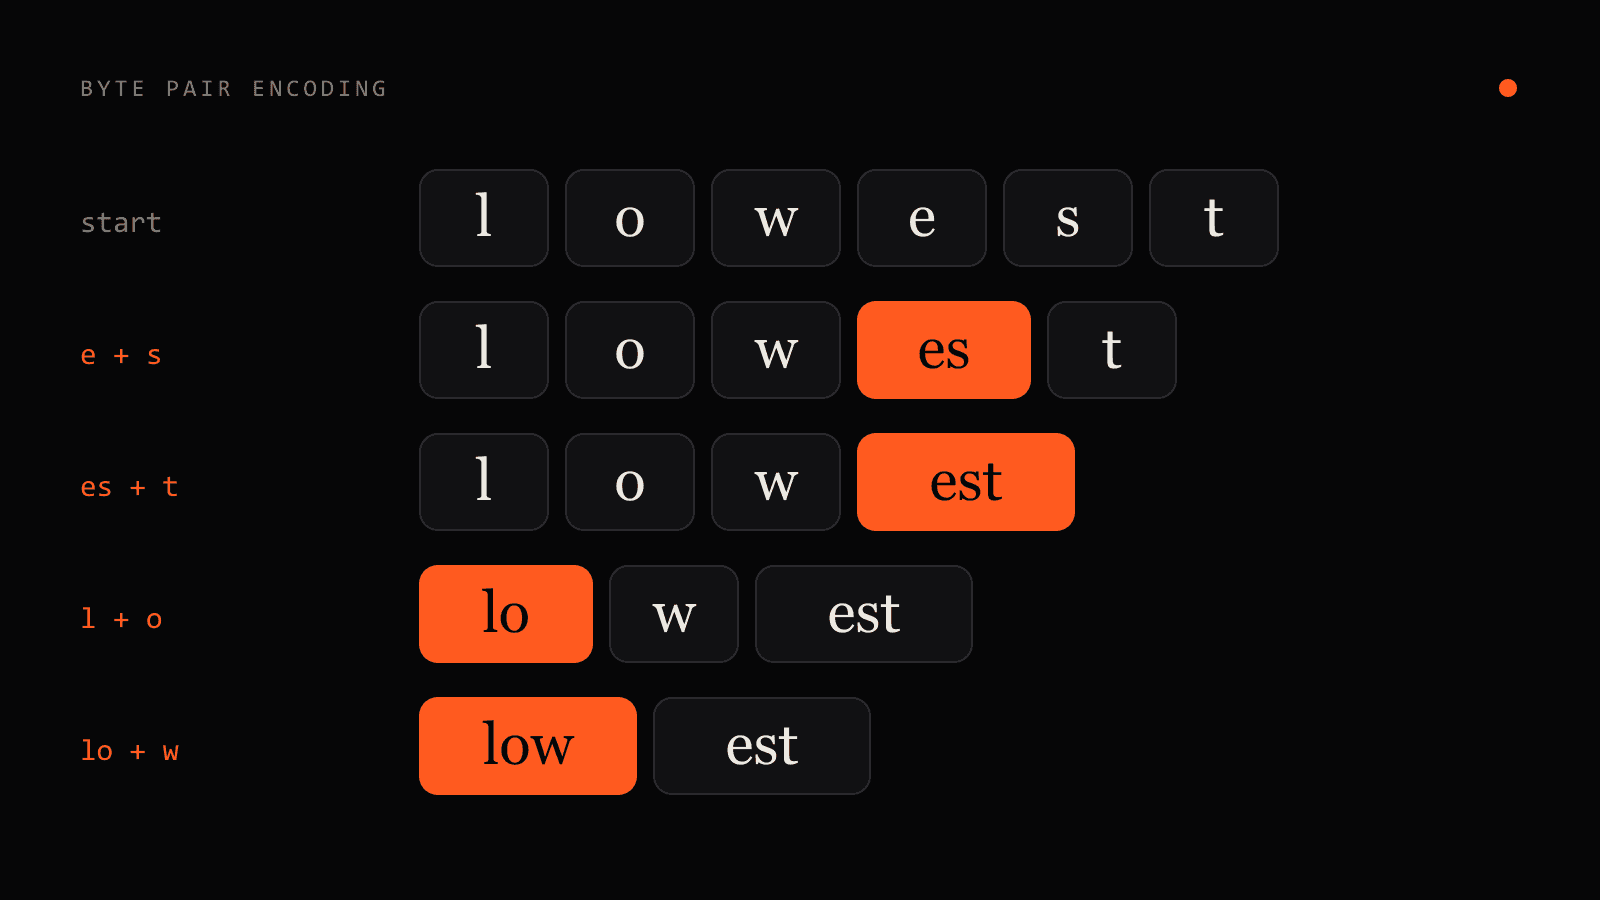
Byte pair encoding (BPE) en küçük birimlerle başlar ve tek bir adımı tekrarlar: yan yana gelen bütün çiftleri say, en sık geçen çifti yeni bir birim olarak birleştir. Bu birleştirmelerin sıralı listesi, tokenizer’ın kendisidir.
Dört kelimelik ve tekrar sayıları belli küçük bir derlem bunu gösterir:
low × 5     lower × 2     newest × 6     widest × 3

start    l o w        l o w e r      n e w e s t     w i d e s t
merge 1  e + s → es   (9 times: newest 6 + widest 3)
merge 2  es + t → est (9 times)
merge 3  l + o → lo   (7 times: low 5 + lower 2)
merge 4  lo + w → low (7 times)

result   low          low e r        n e w est       w i d est
Dört birleştirmeden sonra “low” tek token’dır, “est” de yeniden kullanılabilen bir ek. Tokenizer’ın hiç görmediği “lowest” gibi bir kelime hata vermek yerine low + est olarak çıkar. Gerçek tokenizer’lar çok büyük bir derlem üzerinde on binlerce birleştirme yapar, ama döngü aynıdır.
tiktoken README’si bu yöntemi kullanışlı kılan özellikleri sıralar: tersine çevrilebilir ve kayıpsızdır, yani token’lar özgün metne geri dönüşür; ve tokenizer’ın eğitim verisinde olmayan metinler dahil her metinde çalışır. Pratik bir ortalama da verir: her token yaklaşık 4 bayta karşılık gelir [2].
Aynı cümle İngilizce dışında neden daha pahalı#
Farsça ve Türkçe gibi dillerin aleyhine iki şey çalışır.
Birincisi baytlardır. Baytlardan başlayan bir tokenizer, bayt düzeyindeki BPE gibi, metni UTF-8 olarak görür. UTF-8’de U+007F’ye kadar olan karakterler bir bayt, U+0080 ile U+07FF arasındakiler iki bayt tutar [6]. Farsça için kullanılan Arap yazısının bütün harfleri ve ş, ğ, ı gibi Türkçe harfler bu ikinci aralıktadır:
"salam"   5 characters   5 bytes
"سلام"    4 characters   8 bytes
İkincisi eğitim verisidir. Birleştirmeler sıklıktan öğrenilir. Çoğunlukla İngilizce metinle eğitilen bir tokenizer uzun İngilizce parçalar öğrenir, geri kalan her şey için yalnızca kısa parçalar; böylece diğer diller ham baytlara daha yakın kalır.
Bu ölçüldü. Petrov ve arkadaşları, farklı dillere çevrilen aynı metnin tokenizasyon uzunluğunun çok farklı olabildiğini, bazı durumlarda farkın 15 kata kadar çıktığını buldu. Sonuçlarına da dikkat çekiyorlar: ticari dil hizmetlerine erişim maliyeti, işlem süresi ve gecikme, ve bağlama sığan içerik miktarı [5].
OpenAI’nin kendi rehberi de bununla tutarlıdır. İngilizce için pratik kurallar verir (bir token yaklaşık 4 karakter ya da bir kelimenin dörtte üçüdür) ve bunların tahmin olduğunu, diğer dillerde karakter, kelime ve token ilişkisinin farklı olabileceğini ekler [3].
Diğer tokenizer’lar#
BPE tek yöntem değildir. SentencePiece alt kelime modellerini doğrudan ham cümlelerden eğitir; önceki araçlar ise metnin önceden kelimelere bölündüğünü varsayıyordu [4]. Bu, kelimeler arasına boşluk koymayan diller için önemlidir. Her model ailesi kendi tokenizer’ı ile gelir; birinde saydığınız token sayısı diğeri için geçerli değildir.
Pratikte ne yapmalı#
Sayın, tahmin etmeyin. Çağırdığınız modele ait tokenizer’ı çalıştırın:
import tiktoken

enc = tiktoken.get_encoding("cl100k_base")
tokens = enc.encode("Your prompt goes here")
print(len(tokens))
Yukarıdaki bölümlerden birkaç alışkanlık çıkar:
- Prompt’ları kullanıcılarınızın yazdığı dilde ölçün. Yalnızca İngilizce ile denenmiş bir bütçe Farsça ya da Türkçe için yetmez.
- Getirme parçalarının boyutunu karakterle değil token ile belirleyin; böylece her dilde aynı anlama gelir. Parçalamayı Retrieval-augmented generation yazısında anlattım.
- Yanıta yer bırakın. Girdi ve çıktı aynı bağlam penceresini paylaşır; bunu özgün makaleden Transformer yazısında açıkladım.
- Model değiştirdiğinizde yeniden sayın. Farklı bir tokenizer aynı metin için farklı bir sayı verir.
Özet#
- Token, sabit bir sözlükten gelen bir metin parçasıdır; sınırlar ve fiyatlar token ile sayılır.
- BPE bu sözlüğü, yan yana en sık geçen çifti tekrar tekrar birleştirerek kurar [1].
- Tersine çevrilebilir ve her metinde çalışır; ortalama olarak token başına yaklaşık 4 bayt [2].
- İngilizce dışındaki metin genellikle daha fazla token ister: UTF-8’de harf başına daha çok bayt [6] ve daha az öğrenilmiş birleştirme. 15 kata varan farklar ölçüldü [5].
- Pratik kurallar İngilizce içindir [3]. Gerçek tokenizer ile sayın.
Kaynaklar#
- Sennrich, R., Haddow, B., Birch, A. “Neural Machine Translation of Rare Words with Subword Units.” 2015, accepted at ACL 2016. https://arxiv.org/abs/1508.07909
- OpenAI. tiktoken, README (“What is BPE anyway?”). https://github.com/openai/tiktoken
- OpenAI Help Center. “What are tokens and how to count them?” https://help.openai.com/en/articles/4936856-what-are-tokens-and-how-to-count-them
- Kudo, T., Richardson, J. “SentencePiece: A simple and language independent subword tokenizer and detokenizer for Neural Text Processing.” 2018. https://arxiv.org/abs/1808.06226
- Petrov, A., La Malfa, E., Torr, P. H. S., Bibi, A. “Language Model Tokenizers Introduce Unfairness Between Languages.” NeurIPS 2023. https://arxiv.org/abs/2305.15425
- Yergeau, F. “UTF-8, a transformation format of ISO 10646.” RFC 3629, section 3. https://www.rfc-editor.org/rfc/rfc3629
- #ai
- #llm
- #tokenization
- #bpe
- #research
Yazan: Parsa Alizadeh
Web ve mobil ürünleri baştan sona geliştiriyorum; onları daha akıllı hale getiren yapay zekâ araçlarıyla birlikte. Hızlı arayüzler, temiz sistemler ve işi teslim etmek benim için önemli.