Erişimle zenginleştirilmiş üretim: orijinal makaleden çalışan bir işlem hattına
Adını koyan 2020 tarihli makaleye göre RAG’in ne olduğu, pratik bir işlem hattının parçaları ve araştırmaların erişilen metnin istemde nereye konması gerektiği konusunda söyledikleri.
 Parsa Alizadeh
2 dk okuma
Bu sayfada
Büyük dil modelleri, eğitim sırasında edindikleri bilgilerle cevap verir. Bu bilgi güncelliğini yitirmiş, eksik ya da bir kaynağa dayandırılması imkânsız olabilir. Genellikle RAG olarak kısaltılan erişimle zenginleştirilmiş üretim (retrieval-augmented generation), bir modele cevap verdiği anda doğru bilgiyi sağlamanın en yaygın yoludur. Bu yazı, terimi ortaya atan makaleyle başlıyor ve ardından işlem hattının genellikle nasıl kurulduğunu anlatıyor.
İsim nereden geliyor#
Terim, Patrick Lewis ve arkadaşlarının NeurIPS 2020’de yayımlanan “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks” makalesinden geliyor [1].
Makale iki tür bellek tanımlar [1]:
- Parametrik bellek: önceden eğitilmiş bir diziden diziye (sequence-to-sequence) modelin ağırlıklarında saklanan bilgi.
- Parametrik olmayan bellek: önceden eğitilmiş bir sinirsel erişiciyle (retriever) erişilen, Wikipedia’nın yoğun vektör dizini.
RAG bu ikisini birleştirir. Erişici ilgili pasajları bulur, üretici (generator) de çıktısını bu pasajlara koşullu olarak yazar.
Makale iki formülasyonu karşılaştırır [1]. Biri, üretilen dizinin tamamı boyunca aynı erişilmiş pasajlara koşullanır (RAG-Sequence). Diğeri ise her token için farklı pasajlar kullanabilir (RAG-Token).
Yazarlar, RAG modellerinin yalnızca parametrik bir temel modele (baseline) kıyasla daha spesifik, daha çeşitli ve olgusal açıdan daha doğru bir dil ürettiğini ve birkaç açık alan soru cevaplama görevinde en iyi sonuçları (state of the art) elde ettiğini bildiriyor [1].
Adım adım işlem hattı#
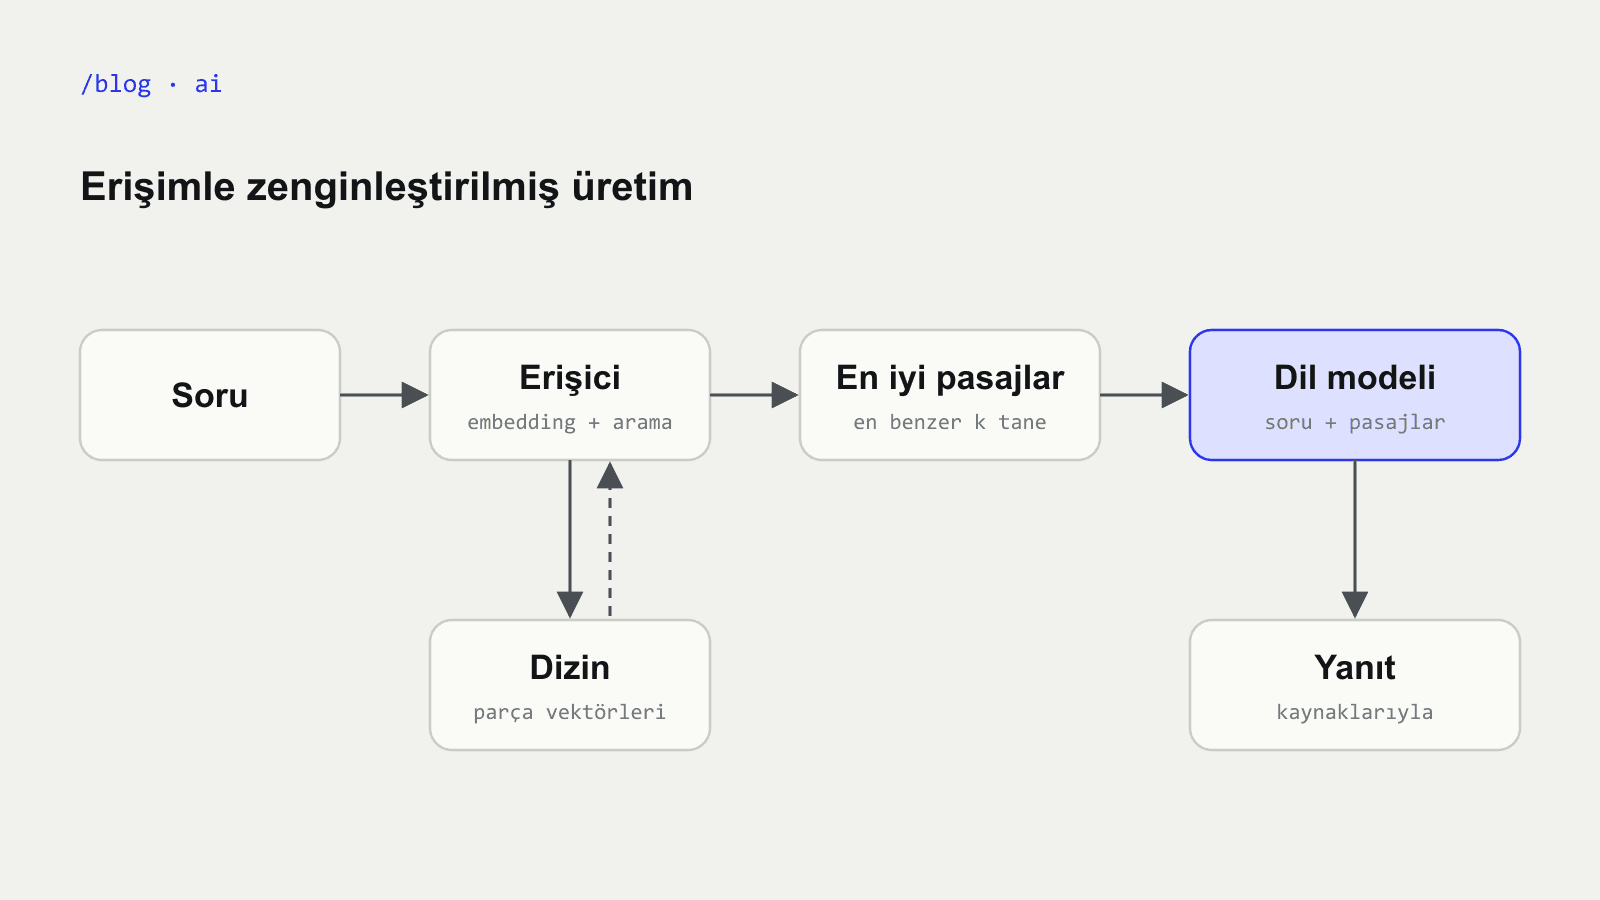
Bugün kurulan RAG sistemlerinin çoğu, Wikipedia yerine harici bir dizin kullanarak makaledekiyle aynı yapıyı izler:
- Kaynak belgeleri, genellikle parça (chunk) denen pasajlara bölün.
- Her parçayı, metni vektöre dönüştüren bir gömme (embedding) modeliyle gömün.
- Vektörleri, benzer olanlar hızla bulunabilecek şekilde dizinleyin.
- Vektörleri gömülmüş soruya en yakın olan parçaları getirin.
- Cevabı, soruyu erişilen parçalarla birlikte vererek bir dil modeliyle üretin.
Cevap belirli pasajlardan oluşturulduğu için sistem hangilerini kullandığını gösterebilir. Çoğu zaman RAG kurmanın asıl nedeni de budur: doğrulanabilen cevaplar.
Erişilen metnin nereye konduğu önemlidir#
Bir modele daha fazla bağlam vermek kendiliğinden daha iyi sonuç vermez. Nelson F. Liu ve arkadaşları “Lost in the Middle” çalışmasında, model performansının ilgili bilgi girdinin başında ya da sonunda yer aldığında çoğu zaman en yüksek olduğunu, uzun bir bağlamın ortasında yer aldığında ise belirgin şekilde düştüğünü buldu [2]. Bu durumu uzun bağlamlar için tasarlanmış modellerde bile gözlemlediler [2].
Bundan iki pratik sonuç çıkar:
- Bağlam penceresinin izin verdiği kadar çok pasaj yerine daha az ama daha iyi pasaj getirin.
- En ilgili pasajları, modelin onları kullanma olasılığının en yüksek olduğu yere, yani bağlamın başına ya da sonuna koyun.
Özet#
- RAG, harici bir dizin üzerinde çalışan bir erişiciyi, erişilen içerikten yazan bir üreticiyle eşleştirir [1].
- Pratik işlem hattı şu adımlardan oluşur: bölme, gömme, dizinleme, erişim, üretim.
- Konum önemlidir: bağlamın başındaki ya da sonundaki ilgili metin, ortadaki metne göre daha güvenilir şekilde kullanılır [2].
- Asıl fayda, gösterebileceğiniz kaynaklara dayanan cevaplardır.
Farklı bir konuya geçecek olursak, bunun gibi teknik yazıları kendi adınızla yayımlıyorsanız yapılandırılmış verilerle kendinizi arama motorlarına tanıtmak işinize yarar.
Kaynaklar#
- Lewis, P., Perez, E., Piktus, A., Petroni, F., Karpukhin, V., Goyal, N., Küttler, H., Lewis, M., Yih, W., Rocktäschel, T., Riedel, S., Kiela, D. “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks.” NeurIPS 2020. https://arxiv.org/abs/2005.11401
- Liu, N. F., Lin, K., Hewitt, J., Paranjape, A., Bevilacqua, M., Petroni, F., Liang, P. “Lost in the Middle: How Language Models Use Long Contexts.” 2023. https://arxiv.org/abs/2307.03172
- #ai
- #llm
- #rag
- #retrieval
Yazan: Parsa Alizadeh
Web ve mobil ürünleri baştan sona geliştiriyorum; onları daha akıllı hale getiren yapay zekâ araçlarıyla birlikte. Hızlı arayüzler, temiz sistemler ve işi teslim etmek benim için önemli.