Orijinal makalesinden Transformer: geliştiriciler için dikkat mekanizması
Ölçeklenmiş nokta çarpımı dikkati, çok başlı dikkat ve konumsal kodlamanın nasıl çalıştığı; formüller ve ayarlar doğrudan “Attention Is All You Need” makalesinden alınmıştır.
 Parsa Alizadeh
3 dk okuma
Bu sayfada
Bugün kullanılan büyük dil modellerinin çoğu tek bir mimari üzerine kuruludur: Transformer. Bu mimari, 2017’de yayımlanan kısa, kesin ve nasıl çalıştığını öğrenmek için hâlâ en iyi kaynak olan bir makaleyle tanıtıldı. Bu yazı, makalenin kendi formüllerini ve sayılarını kullanarak mimarinin merkezindeki mekanizmayı, yani dikkati (attention) adım adım ele alıyor.
Makale#
“Attention Is All You Need”, Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Łukasz Kaiser ve Illia Polosukhin tarafından yazıldı ve ilk olarak 12 Haziran 2017’de yayımlandı [1].
Makalenin temel iddiası özette yer alır: Transformer, yinelemeyi (recurrence) ve evrişimleri (convolutions) tamamen bir kenara bırakarak yalnızca dikkat mekanizmalarına dayanır [1]. Ondan önce öncü dizi modelleri, metni yinelemeli ağlarla adım adım işliyordu. Dikkat ise her konumun diğer tüm konumlara doğrudan bakmasını sağlar.
Ölçeklenmiş nokta çarpımı dikkati#
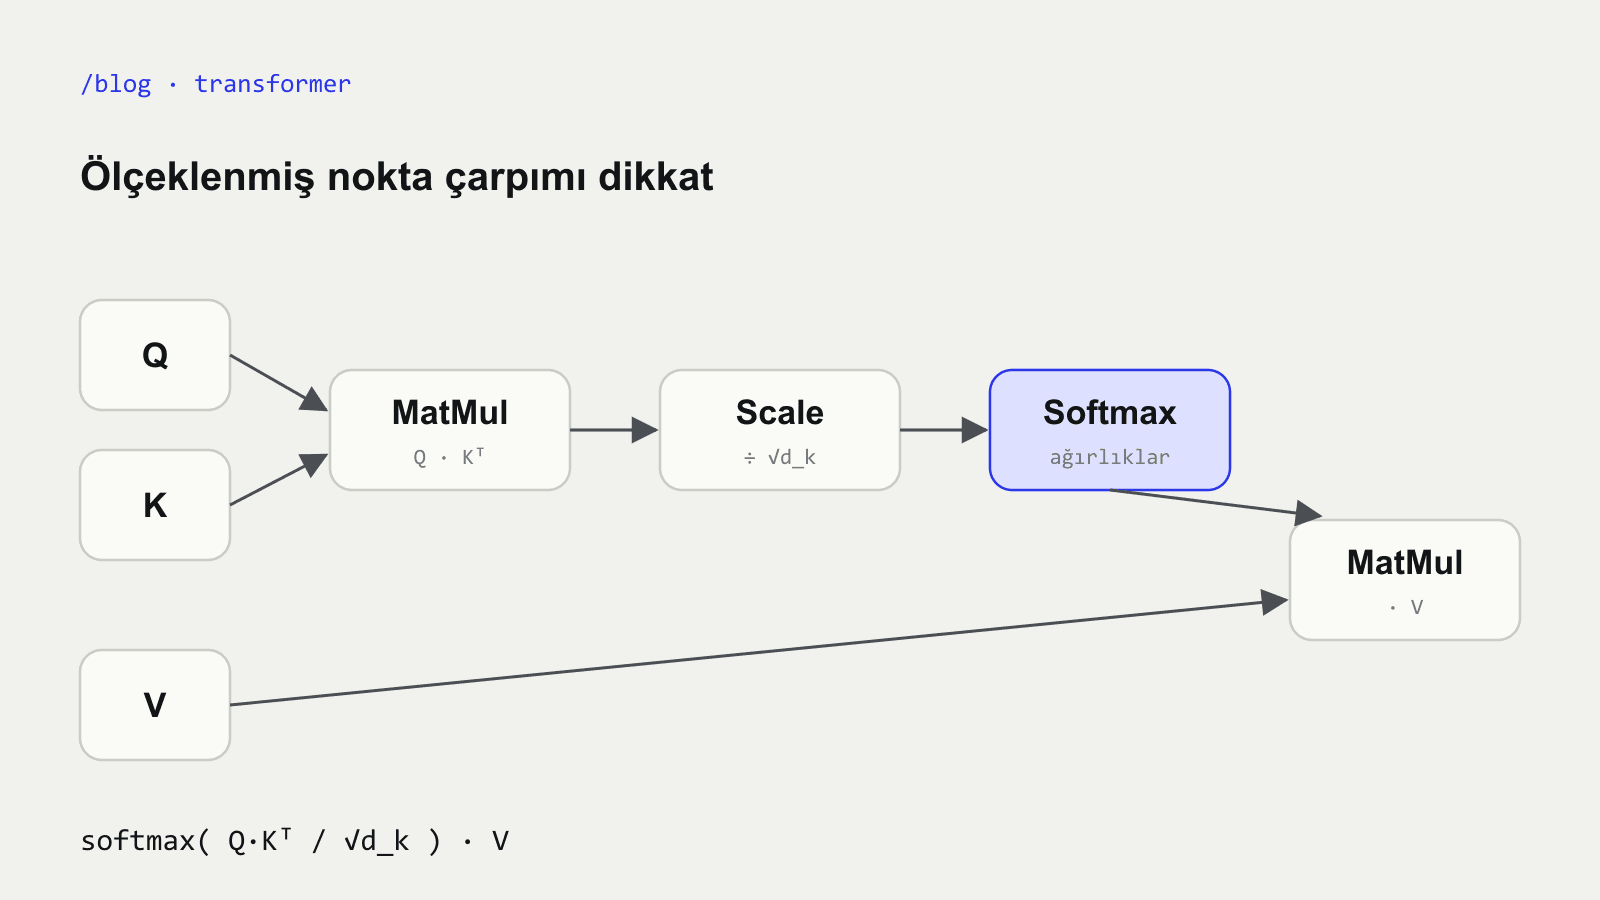
Dikkat üç matris alır: sorgular Q, anahtarlar K ve değerler V. Makale dikkati şöyle tanımlar [2]:
Attention(Q, K, V) = softmax( Q·Kᵀ / √d_k ) · VFormülü içeriden dışarıya doğru okuyun:
- Q·Kᵀ, nokta çarpımlarını kullanarak her sorgunun her anahtarla ne kadar iyi eşleştiğini puanlar.
- ÷ √d_k puanları ölçekler; burada
d_kanahtarların boyutudur. - softmax, her puan satırını pozitif ve toplamı 1 olan ağırlıklara dönüştürür.
- · V, bu ağırlıkları kullanarak değerlerin ağırlıklı ortalamasını alır.
Neden √d_k’ye bölünür#
Makale, büyük d_k değerlerinde nokta çarpımlarının büyüklüğünün arttığını ve softmax’ı gradyanların son derece küçük olduğu bölgelere ittiğini açıklar [2]. Sorguların ve anahtarların bileşenleri ortalaması 0, varyansı 1 olan bağımsız değişkenlerse nokta çarpımlarının ortalaması 0, varyansı ise d_k olur [2]. √d_k’ye bölmek varyansı yeniden 1’e indirir ve bu da eğitimi kararlı tutar.
Çok başlı dikkat#
Tek bir dikkat fonksiyonu girdiye tek bir açıdan bakar. Çok başlı dikkat (multi-head attention) ise her biri kendi öğrenilmiş izdüşümlerine sahip birkaç dikkat fonksiyonunu paralel çalıştırır ve sonuçları birleştirir [2]:
MultiHead(Q, K, V) = Concat(head₁, …, head_h) · Wᴼ
where headᵢ = Attention(Q·Wᵢᵠ, K·Wᵢᴷ, V·Wᵢⱽ)
Makaledeki temel model h = 8 baş kullanır; d_model = 512 ve d_k = d_v = d_model / h = 64’tür [2]. Her baş daha küçük bir boyutta çalıştığı için toplam maliyet, tam boyutlu tek bir başın maliyetine yakındır [2].
Konumsal kodlama#
Dikkatin kendi başına bir sıra algısı yoktur: girdiyi bir küme gibi ele alır. Makale, her girdi gömmesine farklı frekanslardaki sinüs ve kosinüs fonksiyonlarını kullanan bir konumsal kodlama (positional encoding) ekler [2]:
PE(pos, 2i)   = sin( pos / 10000^(2i / d_model) )
PE(pos, 2i+1) = cos( pos / 10000^(2i / d_model) )
Burada pos dizideki konum, i ise boyuttur.
Rakamlarla tam model#
- Kodlayıcı (encoder) ve kod çözücü (decoder), her biri N = 6 özdeş katmandan oluşan birer yığındır [2].
- WMT 2014 İngilizce-Almanca çeviri görevinde model 28,4 BLEU, İngilizce-Fransızca görevinde ise 41,8 BLEU puanına ulaştı [1].
- İngilizce-Fransızca görevindeki 41,8 BLEU sonucu, sekiz GPU üzerinde 3,5 günlük eğitimin ardından elde edildi [1].
Geliştiriciler için neden önemli#
Bu tasarımın iki sonucu, bugün dil modelleriyle nasıl geliştirme yaptığımızı belirliyor. Her konum diğer tüm konumlara dikkat ettiği için dikkatin maliyeti dizi uzunluğunun karesiyle artar; bağlam pencerelerinin gerçek bir sınır olmasının nedeni budur. Ayrıca dikkat tüm konumları aynı anda tarttığı için bağlama neyi ve nereye koyduğunuz çıktıyı etkiler. Bunun pratik tarafını Erişimle zenginleştirilmiş üretim yazısında anlattım.
Özet#
- Transformer, yinelemenin ve evrişimlerin yerine dikkati koyar [1].
- Dikkat
softmax(Q·Kᵀ / √d_k) · Vşeklindedir;√d_k, softmax’ı düşük gradyanlı bölgelerin dışında tutar [2]. - Temel model 64 boyutlu 8 baş,
d_model = 512ve kodlayıcı ile kod çözücünün her birinde 6 katman kullanır [2]. - Sinüzoidal konumsal kodlamalar modele bir sıra algısı kazandırır [2].
Kaynaklar#
- Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., Polosukhin, I. “Attention Is All You Need.” 2017. Abstract: https://arxiv.org/abs/1706.03762
- The same paper, full text (sections 3.2 and 3.5): https://arxiv.org/html/1706.03762v7
- #ai
- #transformer
- #attention
- #deep-learning
- #research
Yazan: Parsa Alizadeh
Web ve mobil ürünleri baştan sona geliştiriyorum; onları daha akıllı hale getiren yapay zekâ araçlarıyla birlikte. Hızlı arayüzler, temiz sistemler ve işi teslim etmek benim için önemli.