Vektör arama komşuları nasıl hızla bulur: gömmeler, benzerlik ve HNSW
Tam en yakın komşu aramasının neden ölçeklenmediği, yaklaşık aramanın neyden ödün verdiği ve Malkov ile Yashunin’in makalesindeki HNSW grafının yakın vektörleri nasıl hızla bulduğu.
 Parsa Alizadeh
3 dk okuma
Bu sayfada
Erişimle zenginleştirilmiş her yapay zekâ sisteminin merkezinde aynı soru vardır: bir sorgu vektörü verildiğinde, saklanan vektörlerden hangileri ona en yakındır? Bu soruyu milyonlarca vektör arasında hızla cevaplamak bir vektör dizininin işidir. Bu yazı, problemi ve en yaygın kullanılan çözümlerden birini, yani Hiyerarşik Gezinilebilir Küçük Dünya (Hierarchical Navigable Small World) grafını, kısaca HNSW’yi açıklıyor.
Gömmeler ve benzerlik#
Gömme (embedding), bir metin parçasını, bir görseli ya da başka bir öğeyi temsil eden bir sayı listesi, yani bir vektördür. Gömme modelleri, anlamca benzer öğelerin birbirine yakın vektörlere sahip olacağı şekilde eğitilir.
“Yakın” kavramının bir tanıma ihtiyacı vardır. Yaygın tanımlardan biri, iki vektör arasındaki açının kosinüsü olan kosinüs benzerliğidir (cosine similarity):
cosine(a, b) = (a · b) / (‖a‖ · ‖b‖)Değeri −1 ile 1 arasında değişir ve vektörler aynı yönü gösterdiğinde 1 olur. Uzunluğu 1’e normalize edilmiş vektörlerde kosinüs benzerliği nokta çarpımına eşittir; birçok sistemin gömmeleri bir kez normalize edip ardından nokta çarpımıyla karşılaştırmasının nedeni budur.
Tam arama neden ölçeklenmez#
Kesin cevabı hesaplamak basittir: sorguyu saklanan her vektörle karşılaştırın ve en iyisini tutun. Bu, her sorgu için saklanan vektör başına bir karşılaştırmaya mal olur; dolayısıyla iş yükü koleksiyonun boyutuyla doğrusal olarak artar. Milyonlarca vektör ve saniyede çok sayıda sorgu söz konusu olduğunda bu, darboğaz hâline gelir.
Yaklaşık en yakın komşu (approximate nearest neighbour, ANN) araması bir ödünleşimi kabul eder: çok daha hızlı cevap vermek karşılığında zaman zaman gerçek bir en yakın komşuyu kaçırabilir. Bu ödünleşimin kalitesi genellikle duyarlılık (recall) ile, yani dizinin gerçekte döndürdüğü gerçek en yakın komşuların oranıyla raporlanır.
Makalesinden HNSW#
HNSW, Yu. A. Malkov ve D. A. Yashunin tarafından ilk olarak 30 Mart 2016’da yayımlanan “Efficient and robust approximate nearest neighbor search using Hierarchical Navigable Small World graphs” makalesinde tanıtıldı [1].
Makale bu yapıyı, saklanan öğelerin iç içe alt kümeleri için her katmanda bir tane olmak üzere, hiyerarşik bir yakınlık grafları kümesinden oluşan çok katmanlı bir yapı olarak tanımlar [1]. Yapının işe yaramasını iki fikir sağlar.
1. Atlamalı listede olduğu gibi rastgele katmanlar#
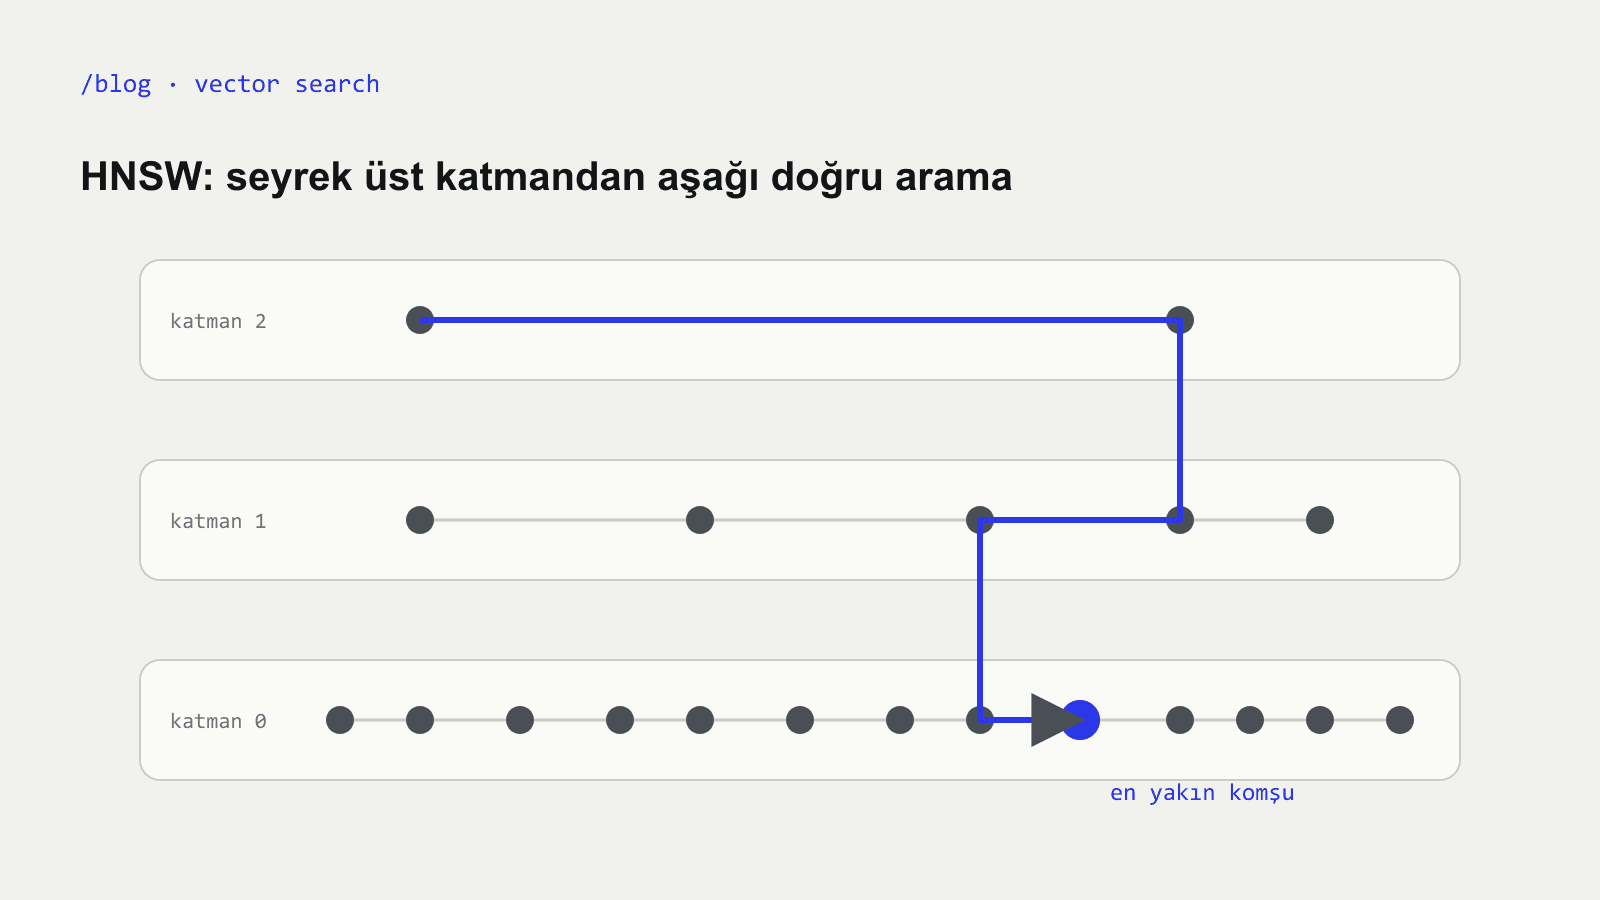
Bir öğe eklendiğinde, yer alacağı en üst katman üstel olarak azalan bir olasılık dağılımıyla rastgele seçilir [1]. Öğelerin çoğu yalnızca en alt katmanda bulunur; birkaçı daha yüksek ve daha seyrek katmanlara ulaşır.
Yazarlar bu benzetmeyi açıkça yapar: HNSW, “bağlı listeler yerine yakınlık graflarının kullanıldığı olasılıksal atlamalı liste (skip list) yapısının bir uzantısı olarak görülebilir” [2].
2. Yukarıdan aşağıya arama#
Arama üst katmanda başlar [1]. Orada bağlantılar uzundur, bu yüzden açgözlü (greedy) bir ilerleme büyük mesafeleri hızla kat eder. Daha fazla yaklaşamadığında bir katman aşağı iner ve daha kısa bağlantılarla devam eder; bu, tüm öğeleri içeren en alt katmana ulaşana kadar sürer. Makale, üst katmandan başlamanın bu ölçek ayrımıyla birlikte logaritmik bir karmaşıklık ölçeklenmesi sağladığını bildirir [1].
Karşılaşacağınız parametreler#
HNSW’yi uygulayan kütüphaneler, makalenin ekleme algoritmasında adı geçen parametreleri sunar [2]:
| Parametre | Makaledeki anlamı |
|---|---|
M | Her yeni öğe için kurulan bağlantı sayısı |
Mmax | Her katmanda öğe başına en fazla bağlantı sayısı |
efConstruction | Dizin oluşturulurken kullanılan dinamik aday listesinin boyutu |
ef | Arama sırasında kullanılan dinamik aday listesinin boyutu; arama kalitesini kontrol eder |
mL | Bir öğenin en üst katmanını seçmek için kullanılan normalizasyon katsayısı |
Makale, mL için basit bir seçim önerir: 1 / ln(M) [2]. Aramanın kalitesini ef belirler [2]: daha büyük bir aday listesi grafın daha büyük bir kısmını keşfeder; bu genellikle duyarlılığı artırır ama zaman maliyeti getirir. Bu değerlerin bir kez belirlenip bırakılmak yerine genellikle bir duyarlılık hedefine göre ayarlanmasının nedeni budur.
Bunun yeri neresi#
Vektör arama, erişimle zenginleştirilmiş üretimin “erişim” adımıdır. Dizin doğru pasajı kaçırırsa dil modeli onu hiç görmez. Bu işlem hattının geri kalanını Erişimle zenginleştirilmiş üretim yazısında, model tarafını ise orijinal makalesinden Transformer yazısında ele aldım.
Özet#
- Gömmeler öğeleri vektörlere dönüştürür; çoğunlukla kosinüs benzerliği olan benzerlik ölçüsü yakınlığı ölçer.
- Tam arama her vektörle karşılaştırma yapar, bu yüzden maliyeti koleksiyonla doğrusal olarak artar.
- HNSW, atlamalı listede olduğu gibi rastgele atanan katmanlara sahip katmanlı yakınlık grafları kurar ve aramayı seyrek üst katmandan aşağıya doğru yapar [1][2].
- Arama kalitesini
efkontrol eder; onuMveefConstructionile birlikte bir duyarlılık hedefine göre ayarlayın [2].
Kaynaklar#
- Malkov, Yu. A., Yashunin, D. A. “Efficient and robust approximate nearest neighbor search using Hierarchical Navigable Small World graphs.” 2016. Abstract: https://arxiv.org/abs/1603.09320
- The same paper, full text (sections on the algorithm and Algorithm 1): https://arxiv.org/pdf/1603.09320
- #ai
- #vector-search
- #hnsw
- #embeddings
- #research
Yazan: Parsa Alizadeh
Web ve mobil ürünleri baştan sona geliştiriyorum; onları daha akıllı hale getiren yapay zekâ araçlarıyla birlikte. Hızlı arayüzler, temiz sistemler ve işi teslim etmek benim için önemli.